FLVM:把异构行为反馈当作"带混杂的测量"——YouTube Shorts 的因子化潜在价值模型
Google(Mountain View / New York)与 YouTube,RecSys '26(Minneapolis)工业短文,arXiv 2609.32839v1,2026-09-26。作者 10 人,一作 Shuo Chang,末位 Ningren Han(YouTube)。正文约 5 页 + 参考文献,共 7 页,CC-BY 4.0。论文提出 Factorized Latent Value Model(FLVM):把观看时长、完播、点赞、点踩、问卷等异构反馈视为一个低维、因子化"潜在价值状态"的带噪测量,用一条只看测量混杂特征(时长、用户倾向、会话上下文)的受限基线路径 吸收可预测的混杂变化,再用路由到各反馈头的潜在路径 解释剩余的偏好相关变化;上线时替换 YouTube Shorts 的生产多任务 pre-scoring 模型,14 天 A/B 主观看享受指标 +2.67%,护栏中性。
研究动机与背景
推荐系统只能"看到行为",看不到偏好
论文开门见山:推荐系统无法直接观测用户偏好,只能从行为反推。这种推断在低摩擦的连续信息流(short-form video feed)里尤其不可靠——用户通过上滑、点赞、分享、评论、关注创作者来消费一条连续的推荐流,显式反馈极其稀疏,生产系统因此严重依赖观看时长、完播率这类隐式信号(引 YouTube 多任务排序 [9, 26])。
但行为信号并不是偏好的直接观测([11, 25]),它们同时受用户偏好、内容本身、视频时长、会话上下文、系统策略 共同塑造。与"主动选择"式的点击发现页相比,这个问题在沉浸式 feed 中更严重([9, 19])。同一个观测行为可能对应完全不同的内在状态:
- 长时间观看可能是真心喜欢,也可能只是被动消费;
- 短暂观看可能表示不喜欢、很快就满足了,或者主动跳过去找别的。
这种歧义对排序优化的具体伤害
作者列出三类典型扭曲:
- 原始观看时长受视频时长强烈影响——长视频天然能积累更多观看时长;
- 完播率(watch time / duration)目标引入反向偏差——系统性偏好短视频([8, 18, 22, 27]);
- 点赞、点踩、分享等显式行为是更强的偏好指示,但稀疏且高度依赖用户个人习惯。
标准多任务 ranker([9, 12, 26],即 YouTube 的 MMoE 谱系)可以学到这些标签之间的相关性,但它仍然直接优化观测标签本身——而这些标签的含义是依赖时长的、依赖用户的、语义纠缠的。
"测量缺口"(measurement gap)
作者把"推荐系统观测到的行为"与"它真正想测的用户偏好"之间的距离命名为 measurement gap。已有工作表明被动负反馈、问卷响应、显式负向行为能在正向互动之外提供额外证据([14, 15, 21])。本文的做法是把这些异构信号联合当作一个共享潜在价值状态的带噪测量,在原始行为反馈与排序优化之间插入一个显式的测量层(measurement layer)。
论文用脚注专门澄清:"value" 指的是观测互动信号不完美地测量的那个潜在构念(latent construct),不是强化学习里的价值函数,也不是长期用户价值(LTV)。
方法定位与贡献
FLVM 建立在两条线的基础上:潜变量推荐(supervised Gaussian variational bottleneck [1],Multi-VAE [6],Google 自家 VAE 推断用户意图注入序列推荐的先例 [2])与基线相对去偏(Relative Advantage Debiasing, RAD [8])。给定一次 user-item 曝光,模型从 serving 时可用的特征推断一个低维因子化潜在价值,并稀疏地路由到各反馈头的解码器;受限基线路径只以时长、会话上下文、用户倾向为条件,建模观测互动中可由测量混杂因素预测的部分;潜在路径解释剩余变化。
部署上,FLVM 替换了生产系统 pre-scoring 阶段原有的多任务排序模型,其潜变量成为打分公式(scoring formula)的主要输入。
论文列出四条贡献: 1. 把推荐中的偏好学习重新表述为一个测量问题:异构行为信号是潜在用户偏好的带噪、带混杂的观测; 2. 提出 FLVM:受限基线(只看测量混杂特征)+ 稀疏路由的潜在解码器(面向异构反馈); 3. 在生产短视频推荐中实例化:以时长、会话上下文、用户倾向作基线特征,以观看、互动、情感极性(valence)、类满意度标签作反馈头; 4. 在 YouTube Shorts 上离线 + 在线验证:关键反馈预测提升,主观看享受指标 +2.67%、护栏中性,并在新上传内容上保持一致收益。
核心方法:Factorized Latent Value Model
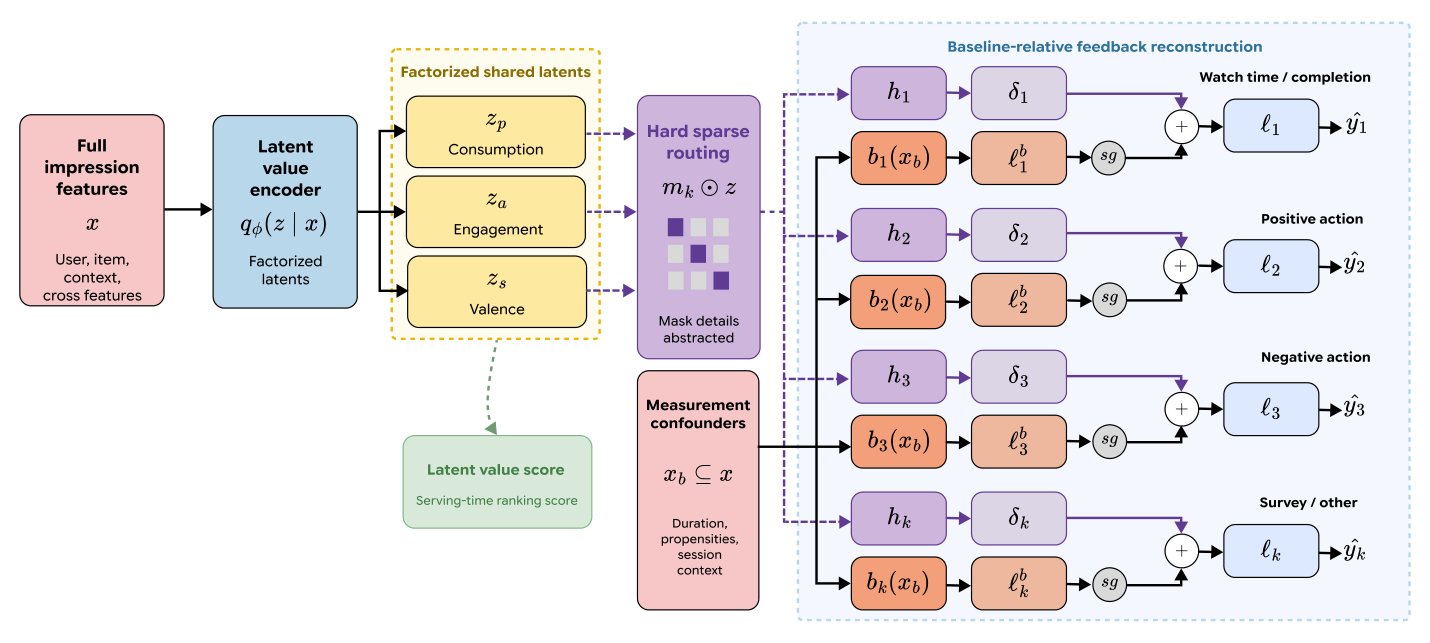
图 1 是全文唯一的架构图,信息量很大,按数据流从左到右读:
- 左:完整曝光特征 $x$(用户、物品、上下文、交叉特征)进入潜在价值编码器 $q_\phi(z\mid x)$;
- 中:编码器输出三个因子化共享潜变量——$z_p$(Consumption,消费)、$z_a$(Engagement,主动互动)、$z_s$(Valence,情感极性);它们经过硬稀疏路由 $m_k\odot z$(图中用 3×3 的格子示意,具体 mask 配置被作者"抽象掉"不公开);同时 $z$ 向下标量化为 serving 用的潜在价值分(latent value score);
- 下中:测量混杂特征 $x_b\subseteq x$(时长、倾向、会话上下文)单独进入每个任务的基线 MLP $b_k(x_b)$;
- 右:每个反馈任务 $k$ 有两条并行支路——潜在支路 $h_k\to\delta_k$ 与基线支路 $b_k(x_b)\to\ell_k^b\to \mathrm{sg}$,二者在 logit 空间相加得 $\ell_k$,再经输出变换得 $\hat y_k$。图中列出四类头:Watch time / completion、Positive action、Negative action、Survey / other。
3.1 问题形式化
作者把行为背后那个未观测的构念称为潜在价值(latent value)。它没有自己的标签,所以模型只能推断它而不能直接优化它;它是曝光级(impression-level) 的,刻画的是特定 user-item 在特定上下文中的偏好相关信号。
对每次曝光,记 $x$ 为 serving 时的特征向量,$x_b\subseteq x$ 为测量混杂特征子集(本文实现中 $x_b$ 包括视频时长、用户倾向、会话上下文)。曝光后观测到 $K$ 个异构反馈信号:
$$ y = \{y_1, y_2, \ldots, y_K\} \tag{1} $$
例如观看时长分桶、完播、点赞、分享、负向行为、问卷式反馈。模型的依赖结构为:
$$ x \rightarrow z, \qquad (x_b, z) \rightarrow y \tag{2} $$
编码器定义潜变量的条件分布 $q_\phi(z\mid x)$。给定 $z$ 与 $x_b$,$K$ 个反馈头条件独立,每个条件分布 $p(y_k\mid z, x_b)$ 由两条结构性路径组合而成:只以混杂特征 $x_b$ 为输入的受限基线路径 $b_k$,以及以潜变量 $z$ 为输入的潜在路径 $h_k$。这个拆分正是本文的架构归纳偏置——把可预测的测量驱动变化路由给基线,让 $z$ 携带偏好相关的残差。两路在 logit 空间组合后经任务专属的输出变换 $o_k$:
$$ \ell_k = f_k\big(b_k(x_b),\, h_k(z)\big), \qquad \hat{y}_k = o_k(\ell_k) \tag{3} $$
其中二值反馈标签的 $o_k$ 为 sigmoid,分类(分桶)标签为 softmax。
作者坦承一个关键事实:编码器看到的是完整的 $x$,所以 $z$ 原则上可以编码 $x$ 的任何函数,包括 $x_b$ 本身。$z$ 只携带残差是训练方案"鼓励"出来的结果,而不是结构上保证的。这一点在后文评估"去混杂是否成立"时至关重要。
3.2 基线与潜在价值优势(advantage)
所有反馈目标都是二值或分桶分类标签,因此每个解码器都在 logit 空间运作。基线路径实现为一个 MLP;潜在路径对路由后的潜变量施加一个严格为正的增益。
受限基线路径 产出基线 logit:
$$ \ell_k^{b} = b_k(x_b) \tag{4} $$
由于 $x_b$ 不含任何 user-video 匹配特征,基线没有直接通往 user-item 相关性的路径——它只能学到"在这个时长、这个用户倾向、这个会话状态下,该反馈平均会是多少"。
潜在路径 产出 logit 尺度的潜在价值优势(latent value advantage):
$$ \delta_k = \gamma_k^{+} \cdot h_k(z) \tag{5} $$
其中 $h_k$ 只依赖路由给任务 $k$ 的那部分 $z$(见 3.3),$\gamma_k^{+}\equiv \mathrm{softplus}(\alpha_k) > 0$ 是每个信号一个的可学习正增益。正性约束的作用是稳定 $z$ 的符号约定,服务于可辨识性(见 3.4)。
最终解码 logit:
$$ \ell_k = \mathrm{sg}(\ell_k^{b}) + \delta_k \tag{6} $$
$\mathrm{sg}(\cdot)$ 为 stop-gradient 算子。这种"基线相对"表述在概念上与观看时长去偏的 relative-advantage 方法 [8] 相关,但把 advantage 思想推广到跨异构反馈信号的残差上。
stop-gradient 的机制含义:由于梯度在 $\ell_k^b$ 处截断,主反馈目标不会回传到基线路径——基线只从 $\mathcal{L}_{\text{base}}$ 获得梯度;而主损失只为"$y_k$ 中尚未被基线解释的部分"奖励 $\delta_k$。这促使混杂效应被基线吸收,产出一个去偏的残差。
作者还对比了一个替代方案:直接让解码器 $p(y_k\mid z, x_b)$ 以基线特征为条件。若没有 stop-gradient 与辅助基线损失,解码器可以自由混合 $x_b$ 与 $z$,$z$ 就没有任何理由只编码残差变化。
解读:式 (6) 本质上是广义线性模型里的 offset 项——先用 $x_b$ 单独拟合一个"期望反馈水平",再把它作为固定偏置,让主模型只拟合相对于它的 logit 偏移。与 YouTube 早年多任务排序系统 [26] 中的 shallow tower(以及 PAL 一类位置偏差塔)相比,差别在于:(i) 基线由独立损失训练、主损失不改它(shallow tower 通常与主塔联合训练);(ii) serving 时不是"丢掉偏差塔的 logit",而是只用潜变量 $z$ 本身来打分(见 3.6)。
3.3 因子化潜在价值变量
潜在价值被因子化为三个分量:
$$ z = [z_p,\, z_a,\, z_s] \tag{7} $$
- $z_p$:消费(consumption) 相关证据;
- $z_a$:主动响应倾向(active response propensity);
- $z_s$:该互动的情感极性(valence)——通过反馈标签表达的、类似情感的正/负极性。
$z_s$ 与 $z_a$ 联合解释深度互动、负反馈、满意度问卷等反馈——因为同一个主动行为既可能是正面反应也可能是负面反应。
作者用一个直观例子论证为什么要因子化:"不同的反馈信号对同一次观看讲述了不同的故事"。三个用户都把一个长视频看完:
- 用户 A 看完就划走;
- 用户 B 看完并点赞;
- 用户 C 看完并点踩。
仅看消费,这三次观看无法区分;只有互动的方向能把 B 与 C 分开,只有是否主动响应能把 A 与 B、C 分开。单个不受约束的潜变量会迫使模型在这些质上不同的信号之间"取平均"。
硬稀疏路由:为了让每个解码器与潜在状态中语义相关的部分对齐,作者用一个每信号一个的硬稀疏路由 mask $m_k$ 限制其潜在路径:
$$ \delta_k = \gamma_k^{+} \cdot h_k(m_k \odot z) \tag{8} $$
mask 把每个反馈解码器限制在因子化潜在状态的一个小子集上:相关任务共享解释因子,无关任务不能随意使用全部潜在维度。路由跟随因子化的语义:消费相关标签只通过 $z_p$ 解释,显式反馈通过 $z_a$ 与 $z_s$ 联合解释。
这一结构约束还让潜在分量的语义更稳定:在无约束的瓶颈里,潜在维度可以任意旋转或混合而不改变预测质量;而在这里,每个分量的含义由它被允许影响的解码器语义组所诱导。
3.4 语义角色的归纳偏置(可辨识性)
作者直面一个常被忽略的问题:给 $z_p, z_a, z_s$ 贴上的语义标签,既不是编码器强制的,也不是标准正态先验能保证的。各向同性先验下的因子化高斯潜变量具有旋转对称与符号对称——目标函数中没有任何东西阻止模型学到三个潜在轴的任意旋转,那样"consumption / engagement / valence"这些标签就毫无意义。
三个架构选择共同削弱这种对称性:
- 路由 mask $m_k$:给每个潜变量分配一组不同的解码器。一个把 $z_p$ 混入 $z_s$ 的旋转,会把消费变化错误地路由进设计用来预测带极性反馈的解码器,从而增加损失;
- 严格正增益 $\gamma_k^{+}$:在共享某个因子的解码器集合内部,这个因子的符号不能翻转而不付出损失代价;
- 带极性的反馈标签锚定 $z_s$ 的符号:显式满意度问卷、负向互动信号的极性锚定了 $z_s$ 的正负方向;观看时长标签的单调性、二值互动强度对 $z_p$、$z_a$ 起类似作用。
作者引用 Locatello et al. [10] 的著名不可能性结论:没有对模型或数据的结构性假设,无监督地恢复解耦表示是不可能的。本文通过"解码器分配 + 符号锚定的标签"提供这种偏置,而非依赖分布假设。
经验证据:点赞的曝光与带显式负反馈的曝光在 valence 因子 $z_s$ 上分得最开,两组相距 1.7–2.0 个标准差,在三个从头独立训练的模型上一致;这种对齐在训练中稳定——三个因子的符号与相对顺序在每次运行中完全相同,并且在线 A/A 测试 中顶线指标中性(即重训后换上去不会引起线上波动)。
3.5 训练目标
训练包含三部分:主反馈损失、辅助基线锚定损失、KL 正则。作者采用带重参数化采样与 KL 正则的监督式高斯变分瓶颈(supervised Gaussian VIB,[1, 5])。编码器是一个 MLP:共享主干 + 分别输出均值与方差的投影,从 serving 时特征产出对角高斯潜变量分布:
$$ q_\phi(z \mid x) = \mathcal{N}\!\left(\mu_\phi(x),\, \mathrm{diag}\big(\sigma_\phi^{2}(x)\big)\right) \tag{9} $$
并向标准正态先验正则:
$$ p(z) = \mathcal{N}(0, I) \tag{10} $$
主反馈损失:训练编码器与路由后的潜在解码器去预测曝光后的反馈:
$$ \mathcal{L}_{\text{main}} = \mathbb{E}_{z\sim q_\phi(z\mid x)}\left[\sum_{k=1}^{K} r_k\, \lambda_k\, \mathrm{CE}_k\big(y_k, \hat{y}_k\big)\right] \tag{11} $$
其中 $r_k\in\{0,1\}$ 是观测 mask,表示反馈标签 $k$ 对该曝光是否有效;$\lambda_k$ 是平衡异构信号的任务权重。观测 mask 对稀疏反馈(如问卷)很重要——缺失不应被当作隐式负例。由于 $\ell_k = \mathrm{sg}(\ell_k^b) + \delta_k$,这个损失只更新编码器与路由后的潜在解码器,不更新基线路径。
辅助基线锚定损失:基线路径用同样的观测标签单独训练,但只以 $x_b$ 为输入:
$$ \mathcal{L}_{\text{base}} = \sum_{k=1}^{K} r_k\, \lambda_k\, \mathrm{CE}_k\big(y_k, \hat{y}_k^{b}\big) \tag{12} $$
其中 $\hat{y}_k^{b} = o_k(\ell_k^{b})$ 是基线预测,$\lambda_k$ 为每任务权重。换言之,基线就是"只知道 $x_b$ 时对 $y_k$ 的最优预测",近似 $\mathbb{E}[y_k\mid x_b]$。
潜变量正则:
$$ \mathcal{L}_{\text{KL}} = D_{\text{KL}}\big(q_\phi(z\mid x)\,\|\,\mathcal{N}(0, I)\big) \tag{13} $$
该项让潜在空间保持居中、校准,降低潜变量退化为任意的任务专属隐藏单元的风险。
总目标:
$$ \mathcal{L} = \mathcal{L}_{\text{main}} + \mathcal{L}_{\text{base}} + \beta\, \mathcal{L}_{\text{KL}} \tag{14} $$
训练步骤化描述(依据 3.2–3.5 整理):
for each minibatch of impressions (x, x_b, y, r):
    mu, sigma  = Encoder_phi(x)                      # 式 (9),x 为完整特征
    z          = mu + sigma * eps,  eps ~ N(0, I)     # 重参数化采样
    for k in 1..K:
        l_b[k]   = b_k(x_b)                           # 式 (4),只看混杂特征
        delta[k] = softplus(alpha_k) * h_k(m_k ⊙ z)   # 式 (8),硬路由
        l[k]     = stopgrad(l_b[k]) + delta[k]        # 式 (6)
    L_main = Σ_k r_k λ_k CE_k(y_k, o_k(l[k]))         # 式 (11):只更新 Encoder 与 h_k
    L_base = Σ_k r_k λ_k CE_k(y_k, o_k(l_b[k]))       # 式 (12):只更新 b_k
    L_KL   = KL(N(mu, sigma^2) || N(0, I))            # 式 (13)
    minimize L_main + L_base + β·L_KL                 # 式 (14)
serving:  score = combine( σ(z_s), softplus(z_p) )    # 3.6,组合形式未公开;z_a 不参与
3.6 排序集成
serving 时,作者用 $\sigma(z_s)$ 与 $\mathrm{softplus}(z_p)$ 把潜变量 $z$ 标量化为每个物品的潜在价值分。$z_a$ 被刻意排除:它刻画的是主动响应倾向,而 $z_s$ 才承载响应的方向——"没有极性的倾向不是偏好的证据",因此 $z_a$ 只是训练期的辅助构念。得到的分数是排序公式的主要输入,替换了原有的多任务 pre-scoring 阶段。
注意两点:(i) 两个量如何组合(相乘、加权和、还是再进一层公式)论文没有给出;(ii) serving 分数只用 $z$,完全不用基线 logit——也就是说,只要 $z$ 真的是"去掉 $x_b$ 可预测部分后的残差",排序就自动对时长中性。这个"只要"就是全文的核心前提。
关键技术细节与未公开信息
这是一篇 5 页短文,大量实现细节被略去,列出以便判断可复现性:
| 项目 | 论文披露情况 |
|---|---|
| 潜变量维度($z_p/z_a/z_s$ 各几维) | 未给出(Figure 2b 以单个 $\Delta z$ 标量展示每个因子,暗示可能各为 1 维或取了汇总量) |
| 反馈头数量 $K$ 与完整列表 | 未给出;正文提到观看时长分桶、完播、点赞、分享、负向行为、问卷式反馈、skip |
| 路由 mask $m_k$ 的具体配置 | 明确"abstracted",不公开;只说消费类→$z_p$,显式反馈→$z_a+z_s$ |
| $\lambda_k$、$\beta$、$\alpha_k$ 初始化 | 未给出 |
| 编码器 / 基线 MLP 规模 | 未给出 |
| 训练数据量、时间窗、评估集 | 未给出 |
| serving 标量化公式 | 只说用 $\sigma(z_s)$ 与 $\mathrm{softplus}(z_p)$,组合方式未给出 |
| 主观看享受指标(primary viewer enjoyment metric)的定义 | 未给出 |
| 护栏指标、流量比例、置信区间 | "standard experiment traffic allocation",护栏"neutral",无 CI / p 值 |
| 冷启动 ">2%" 的指标 | 仅描述为"帮助新视频吸引早期互动并进入主流分发",无定义 |
实验设置
- 平台:YouTube Shorts,十亿级活跃用户的短视频平台;
- 对照:生产 pre-scoring 排序模型——以标准多任务目标训练,外加一个事后分数组合阶段(post-hoc score combination stage)。这是唯一的 baseline,没有任何学术方法(D2Q、CVRDD、CWM、RAD、AlignPxtr 等在 related work 中讨论过的去偏方法)作为对照;
- 离线指标:二值信号用 PR-AUC(越高越好),物品观看时长用 RMSE(越低越好);
- Skip 被排除在跨系统对比之外:两套系统用了不同的 skip 标签定义,不可直接比较——这也说明 FLVM 与生产模型的标签集合并不完全相同;
- 在线:14 天 A/B,标准实验流量分配;
- 稳定性:三次从头独立训练 + 在线 A/A 测试。
主要实验结果
Table 1:相对生产多任务 baseline 的离线预测性能
| Signal | Metric | Production | FLVM | 变化 |
|---|---|---|---|---|
| Item watch time | RMSE ↓ | 24.47 | 23.35 | −4.6% |
| Completion | PR-AUC ↑ | 0.6898 | 0.6722 | −0.0176(−2.6%) |
| Like | PR-AUC ↑ | 0.2522 | 0.3190 | +0.0668(+26.5%) |
| Dislike | PR-AUC ↑ | 0.0038 | 0.0054 | +0.0016(+42.1%) |
作者的解读:FLVM 降低了观看时长 RMSE,提升了 Like 与 Dislike 的 PR-AUC,但 Completion 整体略降。作者随即给出一个按时长分片的分析:在所有指标上,FLVM 在长视频(>60s)上系统性优于 baseline——Completion PR-AUC 平均提升 0.0032;在短视频(<60s)上平均低 0.0053。作者据此论证:生产 baseline 经常利用短视频启发式(短视频天然完播率高)来抬高整体指标,而 FLVM 的表现向"更难消费的长内容"转移,说明它更好地捕获了真实用户偏好;联合地用一个紧凑潜在价值状态解释异构反馈,比逐任务独立的头更能对稀疏、带混杂的信号去噪。
分析(why):
- Like +26.5% 是全表最大的变化,对一个成熟的 YouTube 生产模型而言幅度非常大。可能的来源有三:(a) 基线路径吸收了用户点赞倾向,让潜在路径能专注于 user-item 匹配(作者在 Table 2 中的解释);(b) FLVM 的反馈头/标签定义与生产模型不同(Skip 已被证实不同);(c) 生产模型原本就没有把 Like 作为高权重任务优化。论文没有提供区分这三者的实验。
- Dislike 的绝对值极小(0.0038 → 0.0054),相对提升虽有 42%,但 PR-AUC 仍处于千分之几的量级,说明点踩依然几乎不可预测;这个数字更多是"方向正确"而非"可用"。
- Completion 的整体下降与分片解读之间有张力。若 0.0032 / 0.0053 都指 Completion PR-AUC 的分桶均值,那么整体 −0.0176 的降幅明显大于任一分桶内的变化——PR-AUC 不是分桶 PR-AUC 的平均,额外的下降意味着跨时长桶的排序变差了(把不同时长的视频放在一起比时,FLVM 更差)。而跨时长的差异恰恰是基线路径应当负责的部分。作者把整体下降重新叙述为"去偏的代价/证据",但在离线设置下这个叙事不可证伪:更低的完播预测精度本身并不能证明更好地捕获了偏好,需要问卷等外部标尺才能判断(论文原文"across all metrics"的措辞也让 0.0053 是否专指 Completion 不够明确)。
Table 2:FLVM 两条路径的 PR-AUC 分解
Baseline-only $= o_k(\ell_k^b)$;Latent-only $= o_k(\delta_k)$;Full $= o_k(\ell_k)$。
| Signal | Baseline | Latent | Full |
|---|---|---|---|
| Completion | 0.3065 | 0.6617 | 0.6722 |
| Like | 0.1860 | 0.0715 | 0.3190 |
| Skip | 0.1840 | 0.5016 | 0.5100 |
| Dislike | 0.0035 | 0.0035 | 0.0054 |
作者的解读:所有信号上 Full 都超过任一单路径,说明基线与潜在贡献互补;但依赖程度随信号与物品生命周期而异。
- Like 上的"协同效应":两条路径单独预测 Like 都很差(0.1860 / 0.0715),合起来却远超任一(0.3190,比 baseline-only 高 71.5%)。作者认为这说明点赞这类显式行为被测量混杂特征(如用户倾向)严重遮蔽——把这些混杂交给受限基线后,潜在路径才能恢复偏好相关信号。
- Completion 与 Skip 这类被动行为:潜在路径承担了绝大部分预测力(0.6617 / 0.5016),但基线对达到完整精度仍严格必要。
分析(why):
- 这张表不是消融。Baseline-only 与 Latent-only 都是同一个训练好的完整模型里的子输出,而不是分别训练的模型。潜在路径在训练时就是以 $\mathrm{sg}(\ell^b_k)$ 为偏置去拟合残差的,单独拿 $\delta_k$ 出来评估,本质上是评估一个"残差"的排序能力——Full 大于两个分量几乎是由构造保证的。它能说明两路确实都在承担信息,但不能说明"这种拆分结构比不拆分更好"。
- Like 的模式在机理上可解释:PR-AUC 是跨所有曝光的全局排序指标,点赞率的跨用户差异(有人什么都点赞、有人从不点)占据了大部分全局方差,这正好是基线(含用户倾向)能捕获而残差不含的;残差 $\delta$ 在"同一用户内部"更有意义,但全局评估时被用户间差异淹没。二者相加才同时具备跨用户与用户内的排序力。
- Completion 一行与"基线吸收时长混杂"的叙事存在张力:按论文的动机,时长是完播率最强的混杂因素,一个输入含时长的基线理应对完播有可观的判别力;但 baseline-only 只有 0.3065,而 latent-only 高达 0.6617、几乎等于 Full(0.6722,仅差 0.0105)。这意味着完播的大部分排序能力由潜在路径携带——结合"编码器能看到完整 $x$、包括时长"这一事实,一个合理的推测是 $z$ 仍然编码了相当部分与时长相关的变化。论文没有报告正样本率,无法判断 0.3065 是否接近随机水平,也就无法把这一点坐实,但它至少说明"基线吸收了时长"不能仅凭架构设计就默认成立。
- Dislike:Baseline 与 Latent 单独都是 0.0035,大概率接近正样本基率(即单路几乎无判别力),合起来到 0.0054。
Figure 2:两项主要设计选择的实证验证
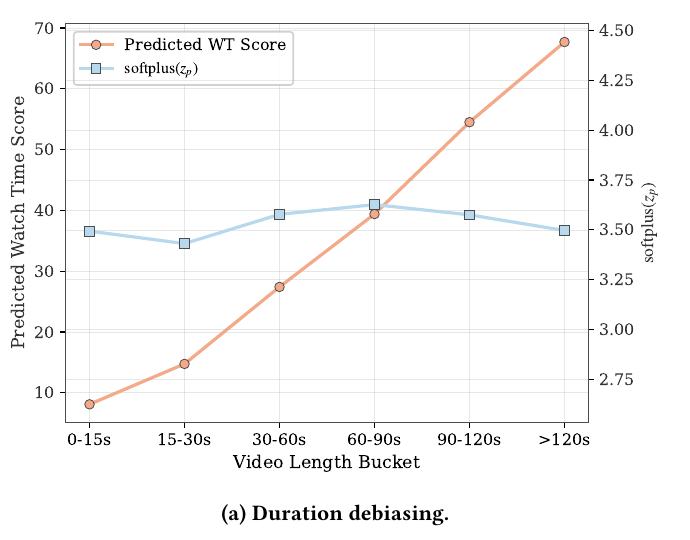
(a) 时长去偏:横轴为视频时长分桶(0-15s、15-30s、30-60s、60-90s、90-120s、>120s)。左轴"Predicted WT Score"(预测观看时长分)从约 8 单调升到约 68,随时长近乎线性增长;右轴 $\mathrm{softplus}(z_p)$ 在 3.43–3.63 之间小幅波动(60-90s 桶最高、15-30s 最低),整体大致平坦。作者据此认为基线路径吸收了时长混杂,served 的消费分对时长中性。
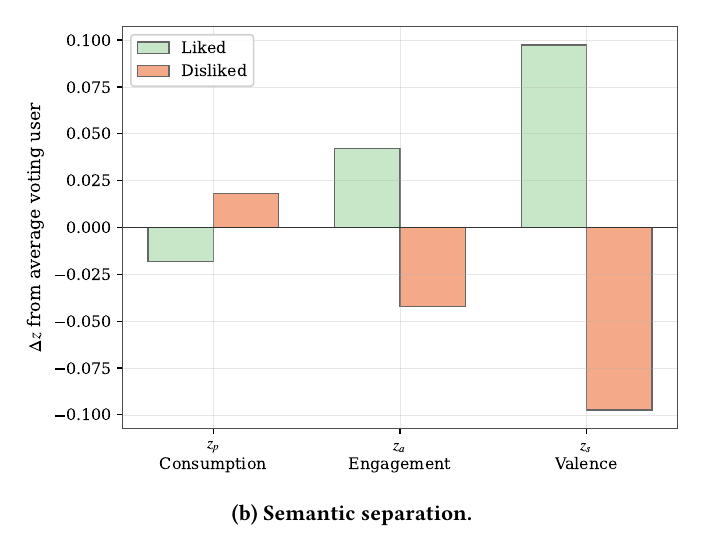
(b) 语义分离:纵轴为"相对平均投票用户的 $\Delta z$"。读图:
| 因子 | Liked | Disliked | 差距 |
|---|---|---|---|
| $z_p$(Consumption) | ≈ −0.018 | ≈ +0.018 | ≈ 0.036(方向:点踩者更高) |
| $z_a$(Engagement) | ≈ +0.042 | ≈ −0.042 | ≈ 0.084 |
| $z_s$(Valence) | ≈ +0.097 | ≈ −0.097 | ≈ 0.194 |
点赞与点踩在 $z_s$ 上分得最开,$z_a$ 次之,$z_p$ 上差距最小——与作者设定的语义一致。
分析(why):
- (a) 的"平坦"是架构的设计目标,而不是外部验证。受限基线以时长为输入、主损失被 stop-gradient 限制只拟合残差,$z_p$ 在时长桶上的均值接近平坦几乎是这个训练目标的直接后果。它能证明"机制按设计运转",但不能证明被去掉的那部分全是混杂:如果用户对某类时长的内容真实地更偏好(或更不偏好),这部分同样可由 $x_b$ 预测,也会被基线吸走——方法把"偏好"操作化定义为"$x_b$ 无法预测的残差",这是一个设计选择而非被验证的事实。此外,桶均值平坦只说明边际上与时长近似独立,不排除时长与 user-item 匹配的交互仍留在 $z$ 中(Table 2 的 Completion 一行恰恰暗示这一点)。
- (b) 用的是训练标签自己:$z_s$ 的解码器本来就被训练去解释点赞/点踩(以及问卷),因此点赞与点踩在 $z_s$ 上分开是循环验证,论文也没说明这些曝光是否来自留出集。
- (b) 中 $z_p$ 并非"近似不变":点踩曝光的 $z_p$ 比点赞曝光更高,差距约为 $z_s$ 差距的 1/5、$z_a$ 差距的一半。由于 serving 分使用单调递增的 $\mathrm{softplus}(z_p)$,这意味着在消费分量上被点踩的内容略占优,最终排序依赖 $\sigma(z_s)$ 去压过它。影响可能不大,但原文"approximately invariant"的措辞偏宽松。
- 正文"相距 1.7–2.0 个标准差"与图中 $\pm 0.1$ 的 $\Delta z$ 并不矛盾:KL 正则会让后验均值在总体上分布得很窄,标准差以后验均值的分布计,数值小但相对分离度大。
在线 A/B 实验
- 时长 / 流量:14 天,标准实验流量分配;
- 对照:生产多任务 pre-scorer(含事后分数组合阶段);
- 结果:主观看享受指标(primary viewer enjoyment metric)+2.67%,护栏指标中性;
- 冷启动切片:在曝光历史有限的新视频上,模型在"帮助新视频吸引早期互动并过渡到主流分发"上取得一致的 >2% 提升;作者据此认为通过把真实偏好与结构性、统计性噪声分离,FLVM 避免了对历史互动的过拟合,能稳健泛化到分布尾部(trailing-edge)数据。
- A/A 稳定性:三次独立重训的模型因子符号与顺序一致,线上 A/A 顶线中性。
消融与分析:缺失的消融,以及对四个关键问题的核查
论文没有任何组件消融
结论部分把方法归纳为三个设计选择——(1) 只看测量混杂特征的受限基线;(2) 代表偏好不同侧面的因子化潜在价值变量;(3) 预定义的硬稀疏解码器路由。这三项没有一项被消融:没有"去掉基线路径"、"去掉 stop-gradient(让解码器自由混合 $x_b$ 与 $z$,即 3.2 里作者自己提到的替代方案)"、"单一无因子化潜变量"、"去掉路由 mask"、"去掉 KL / 换成确定性瓶颈"、"serving 时改用预测的反馈而非 $z$"中的任何一个。Table 2 是路径分解而非消融(见上文)。
核查一:A/B 的对照是什么?
对照是生产多任务 pre-scoring 模型 + 事后分数组合阶段。实验组同时替换了三样东西: 1. 模型结构(VIB 编码器 + 受限基线 + 路由解码器); 2. 反馈头 / 标签集合(Skip 标签定义已被证实不同;问卷式与 valence 类标签是否为生产模型已有,论文未说明); 3. 排序公式本身——从"多个预测值事后组合"变为"$\sigma(z_s)$ 与 $\mathrm{softplus}(z_p)$ 标量化后作为主输入"。
这是一个系统级整体替换的 A/B,而不是"同一套标签、同一套打分,只换建模方式"的对照。
核查二:收益来自潜在价值建模本身,还是新引入的训练信号 / 打分方式?
无法区分。FLVM 的反馈头包含"survey-style feedback"与"satisfaction-like labels",而论文从未说明生产 pre-scorer 是否已经使用这些信号;再加上打分公式整体更换,而主观看享受指标的定义又未公开(若它本身与问卷相关,那么把问卷信号引入训练就可能直接驱动该指标)。按本库的既有原则——引入新信号 ≠ 收益来源——+2.67% 只能记为"FLVM 这一整套系统替换带来的收益",不能记为"潜在价值 / 去混杂机制带来的收益"。一个能回答这个问题的最小实验是:在同一标签集、同一打分组合下,把 FLVM 与"同标签的普通多任务模型"做 A/B,或者把 serving 分换回"预测的反馈 + 原组合公式"。
核查三:去混杂是否被外部 ground truth 验证?
没有。所有"去偏"证据都来自模型自己的目标或训练标签:
- Figure 2(a) 的时长平坦性是架构目标的直接后果;
- Figure 2(b) 用的是被训练去解释的点赞/点踩标签;
- Table 1 的分时长解读是对预测精度变化的事后叙述。
讽刺的是,论文手里有问卷标签——但问卷被当作训练头消耗掉了,而不是留作"FLVM 的潜在价值分是否与问卷报告的满意度更一致"的外部标尺。没有"问卷满意度 vs. 潜在价值分 vs. 原始观看时长"的相关性对比,也没有任何随机化/干预数据上的验证。
核查四:消融降幅是否超过对最强 baseline 的优势?
无法评估——既没有消融,唯一的 baseline 也是生产模型本身。离线上 FLVM 对生产模型是"有涨有跌"(RMSE、Like、Dislike 涨,Completion 跌),并不存在一个统一的"领先幅度"可以拿来与消融对比。
核心贡献总结
- 概念贡献:把"推荐里的偏好学习"明确表述为一个测量问题,用 measurement gap 命名"观测行为 ↔ 潜在偏好"的距离,并澄清 latent value 与 RL 价值函数 / LTV 的区别——这个框架对设计反馈目标很有启发性。
- 结构配方:$\ell_k = \mathrm{sg}(b_k(x_b)) + \gamma_k^{+} h_k(m_k\odot z)$——受限基线用独立损失拟合"混杂可预测部分"、主损失被 stop-gradient 限制只拟合残差、潜在路径经硬路由与正增益进入各头,serving 只用潜变量。
- 可辨识性的工程化处理:认真对待 VIB 潜变量的旋转/符号对称,用"路由 mask + 正增益 + 带极性标签锚定"三件套给出结构性归纳偏置,并用三次独立重训 + A/A 测试证明语义角色稳定——这在工业潜变量模型论文里少见。
- 生产部署:在 YouTube Shorts 替换 pre-scoring 多任务模型,14 天 A/B 主观看享受指标 +2.67%、护栏中性,冷启动切片 >2%。
与已归档相关工作的对比
OrDA OrDA: Orthogonal Disentanglement of Access Habits(Ant Group,2026-07-15)
关系:独立并发(本文未引用 OrDA,两者殊途同归)· 已加载对方精读
- 共同关注的问题:两篇都认为观测到的正反馈被一个与 user-item 匹配无关的混杂因子污染,标准模型会把这部分"红利"误当成兴趣。OrDA 的混杂是用户在首页主入口的访问习惯 / 导航惯性(习惯性伪正样本);FLVM 的混杂是视频时长、用户倾向、会话上下文。两者都把问题上升到"观测 ≠ 偏好"的因果/测量视角,并都强调去混杂后对冷启动更友好(OrDA 的 GAUC_cold,FLVM 的新视频切片)。
- 相近的技术骨架:几乎可以画成同一张图——一条只吃混杂特征的路径(OrDA 的习惯塔只看用户特征 $H=f_H(u)$;FLVM 的基线只看 $x_b$)+ 一条吃完整特征的偏好路径(OrDA 兴趣塔看 $u, c, u2c$;FLVM 编码器看完整 $x$),二者在 logit 空间相加拟合观测标签;混杂路径另有一个只用同一标签训练的辅助损失(OrDA 的 $\mathcal{L}_{Habit}$ 与 FLVM 的 $\mathcal{L}_{\text{base}}$ 形式完全同构);serving 时丢掉混杂路径、只用偏好路径打分(OrDA 的 $do(H=0)\Rightarrow\sigma(I)$;FLVM 只用 $z$ 标量化)。
- 本文的差异与推进:(1) 防泄漏机制不同——OrDA 让两塔联合训练,靠余弦正交正则 + 门控分配层把兴趣向量推离习惯向量;FLVM 不做正交约束,而是用 stop-gradient 让基线完全由辅助损失决定、主损失只能拟合残差,更接近 GLM offset。(2) 多信号 vs 单信号——OrDA 只有 CTR 一个标签;FLVM 把 $K$ 个异构反馈放进同一框架,并引入因子化潜变量、硬路由与符号锚定来处理"同一行为不同极性"的问题,这是 OrDA 没有的维度。(3) serving 对象不同——OrDA 保留兴趣塔的 logit,FLVM 使用潜变量本身的标量化,排序与原反馈头解耦。
- 可比的方法 / 实验差异:两篇都是 5 页工业短文,但实验纪律差别明显。OrDA 有 5 个 baseline(BASE / ESMM / USD / Multi-IPW / PAL)和对 GAL、习惯损失、正交损失、推理干预四个组件的逐项消融(其中"推理时不做干预"降幅最大,直接证明了"丢掉混杂路径"这一步的价值);FLVM 只有一个生产 baseline、零消融。两者有一个共同的结构性弱点:被丢弃的混杂路径里也可能含有真实偏好(OrDA 的 GAUC_active 下降、FLVM 的短视频 Completion 下降都被作者解读为"去偏的代价"),而两篇都没有外部标尺来区分"去掉的是偏差"还是"去掉的是真实偏好"。
讨论与局限性
值得借鉴的设计
- stop-gradient 基线作为"offset":比起正交正则或对抗去偏,这是最简单、最不需要调参的"让一路只学混杂"的办法——基线就是 $x_b$ 上的最优预测器,主模型只能在它之上拟合残差。任何想"把某类因素从 ranker 学到的偏好里剥掉"的场景(时长、位置、设备、入口)都可以直接套用。
- 按信号语义做硬路由 + 正增益 + 极性锚定:这是一个把"多任务头之间的语义关系"写进结构里的实用范式,让潜变量有稳定、可解释的含义,也让重训后的线上行为稳定(A/A 中性)。对需要长期维护、定期重训的工业模型,这种稳定性本身就有价值。
- 把 $z_a$(倾向)排除在打分之外:"没有极性的倾向不是偏好的证据"——这是一个清晰的产品判断:高互动倾向的内容未必是好内容(也可能是引战、引点踩)。
- 观测 mask $r_k$:稀疏的问卷 / 负反馈缺失时不当作负例,这是异构反馈联合训练的必要细节。
主要局限与争议
- 零消融:三个核心设计选择没有一个被单独验证,无法知道收益来自基线拆分、因子化、路由、VIB 还是标签集变化。
- A/B 是系统级整体替换:模型、标签集、打分公式同时变化,+2.67% 无法归因到潜在价值建模本身(引入新信号 ≠ 收益来源)。
- 去混杂缺乏外部验证:时长平坦性是架构目标的直接后果,语义分离用的是训练标签;手中的问卷信号被用作训练目标而非外部标尺。
- "偏好 = $x_b$ 不可预测的残差"是定义而非发现:真实存在的、与时长/用户倾向相关的偏好差异也会被基线吸走,存在"过度去偏"的可能;论文没有讨论这一点。
- 离线结果与叙事的张力:Completion 整体下降被重述为去偏证据,但该叙事在离线设置下不可证伪;Table 2 的 Completion 一行(基线单独很弱、潜在路径几乎承担全部判别力)暗示 $z$ 仍可能携带大量时长相关变化。
- 关键实现细节缺失:潜变量维度、$K$、mask 配置、损失权重、打分组合公式、主指标定义全部不公开,外部几乎不可复现。
- 只有一个 baseline:related work 中讨论的 D2Q、CVRDD、CWM、RAD、AlignPxtr 等去偏方法均未作为对照,无法判断 FLVM 相对既有去偏方案的增量。
- 工业署名 ≠ 工业证据:这篇论文确实有真实的十亿级平台 A/B,这一点比很多"只有署名"的工业稿强;但一个数字、无 CI、指标未定义、不可归因的 A/B,其证据强度也有限。
方法论可扩展性
FLVM 是一个测量层,不是一条 scaling 路线:它刻意用一个低维(每个因子维度未公开,从 Figure 2b 看可能接近标量)的变分瓶颈来承载"偏好",serving 分只由两个标量决定。编码器本身可以随参数量扩展,但最终暴露给排序的信息被瓶颈压到极少的几个数,这对"表征能力随参数量增长"是一个结构性上限——当然作者的目的本来就是去噪与可解释,而不是容量。另一个值得注意的点是它是端到端单阶段训练(基线与潜在路径同时训练,只是梯度隔离),没有"先压缩再建模"式的两阶段解耦问题。它更适合被看作多任务 ranker 之上的"标签/目标设计模块",与骨干的 scaling 基本正交。
工业落地价值
- 部署位置:替换 YouTube Shorts 排序链路中 pre-scoring 阶段的多任务模型,其潜变量成为打分公式的主要输入;
- 业务收益:14 天 A/B,主观看享受指标 +2.67%、护栏中性;冷启动新视频切片 >2%;
- 运维属性:三次独立重训因子符号与顺序一致、线上 A/A 中性——意味着这种潜变量打分在日常重训中不会引入线上抖动,这是潜变量模型能进生产的关键前提,也是本文最具说服力的工程证据之一;
- 可迁移性:对任何"主要优化目标被时长、位置、用户活跃度等因素扭曲"的沉浸式信息流(短视频、直播、音乐、信息流广告),"stop-gradient 受限基线 + 只用残差潜变量打分"的配方都可以低成本试验,但落地时应自行补上本文缺失的两件事:组件消融与以问卷/随机化数据为外部标尺的去偏验证。