LLM-HYPER:把大模型当作超网络,为冷启动广告直接生成 CTR 排序器权重¶
Luyi Ma*, Wanjia Sherry Zhang*, Zezhong Fan*, Shubham Thakur*, Kai Zhao, Kehui Yao, Ayush Agarwal, Rahul Iyer, Jason Cho, Jianpeng Xu, Evren Korpeoglu, Sushant Kumar, Kannan Achan(* 共同一作) Walmart Global Tech, Sunnyvale, California, USA arXiv:2604.12096v1,2026-04-13
1. 研究动机与背景¶
1.1 广告冷启动:不是"数据少",而是"一条标签都没有"¶
在线广告平台不断上新推广活动(promotional ads / campaign)。论文举的典型场景是节庆促销的快速切换——从圣诞档切到新年档:新的一批广告素材上线时,完全没有历史用户反馈,CTR 排序模型的这批广告参数没有任何训练信号。而促销窗口本身很短,冷启动期若处理不当,会直接损害广告相关性与平台收入。
论文特别强调它面对的是严格冷启动(strict cold start):不是"交互稀疏",而是训练阶段完全没有标签。这一点把大量既有冷启动方案排除在外——无论是基于内容相似度做知识对齐的方法(Wei et al., 2021;Huang et al., 2023;Zhou et al., 2023),还是把 MAML(Finn et al., 2017)搬到推荐上的元学习路线(MeLU、MAMO、Vartak et al.),本质上都要求目标物品上存在(哪怕少量)可用于梯度更新的标签。
1.2 为什么目标模型是"线性层"而不是深度网络¶
论文对"要生成什么参数"给出了明确的工业理由:在工业 CTR 排序链路里,线性层被广泛用于两处——
- 把底层交互历史聚合成高层用户偏好表征(McMahan et al., 2013;Cheng et al., 2016;Liang et al., 2020;Wang et al., 2022);
- 对多路信号做最终 CTR 校准(Yan et al., 2022)。
线性层的系数直接就是特征贡献度,天然具备可解释性与可控性。在电商首页这类高风险广告位上,业务方不仅要精度,还要能对品牌、价格等业务策略做审计与干预(Roustaei, 2024)。因此当线性打分函数与复杂深度/LLM 模型集成时,它扮演的是"可解释的控制组件",能缓解黑箱模型的风险。
1.3 为什么不能直接让 LLM 在线排序¶
LLM 具备很强的语义推理能力,已有一批工作让 LLM 直接以自然语言输出推荐结果与解释(P5、M6-Rec、LLaRA、IDGenRec、Triple Modality Fusion 等)。但工业排序系统运行在极端微秒级 p99 延迟约束下,每个排序请求都实时调用重型架构或 LLM 推理在成本与延迟上都不可行。
由此论文把研究问题精确地写成一句话:
如何在没有训练标签(冷启动)的前提下,利用 LLM 的推理能力导出一个线性排序解,同时把昂贵的 LLM 推理与低延迟、快速演进的部署环境解耦(高效部署)?
1.4 核心 insight:LLM 是一个免训练的超网络¶
超网络(hypernetwork,Ha et al., 2016;Chauhan et al., 2024)指"生成另一个网络(目标网络)参数的网络"。既有超网络工作——图超网络做 NAS(Zhang et al., 2018)、参数预测(Knyazev et al., 2021, 2023)、HyperTransformer(Zhmoginov et al., 2022)、MetaDiff(Zhang et al., 2024)、乃至扩散式权重生成(Soro et al., 2024;Xie et al., 2024)——全都依赖训练数据,因而在严格冷启动下同样失效。
LLM-HYPER 的核心主张是:把多模态 LLM 当作一个免训练(training-free)的超网络,输入冷启动广告的图文内容 + 用户特征定义 + 相似暖广告的已训练权重作为 few-shot CoT 示例,让 LLM 直接吐出线性 CTR 预估器的逐特征权重向量。生成过程离线完成、结果缓存,在线只做一次线性点积。
2. 核心方法与模型架构¶
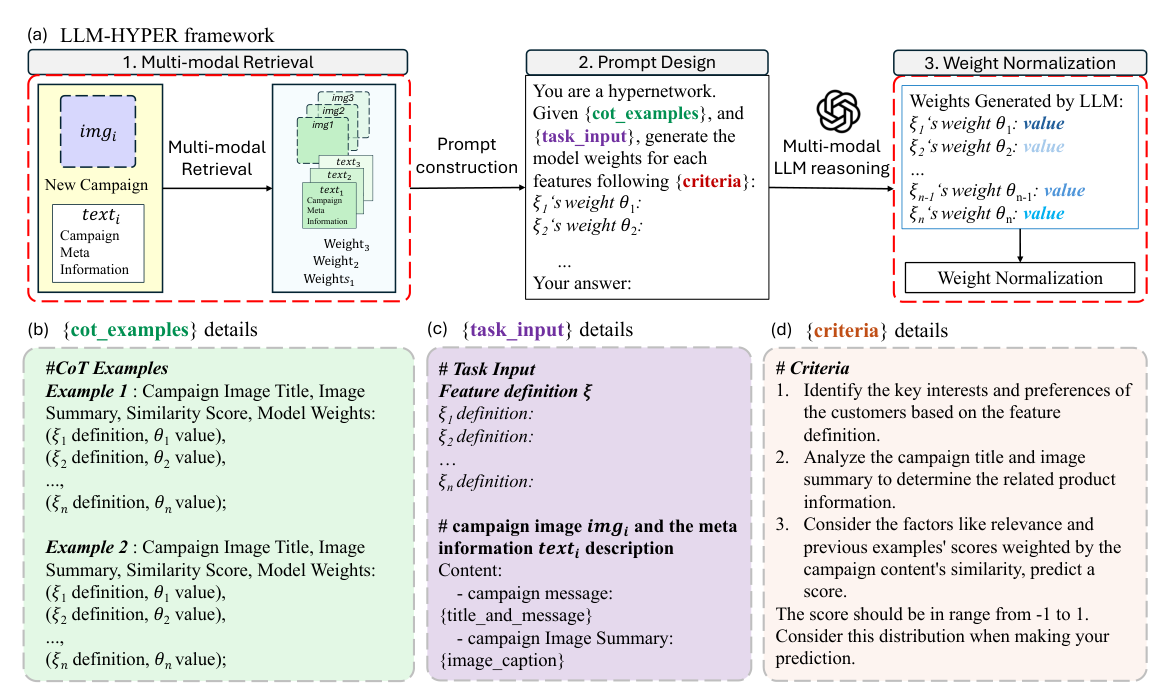
框架分三步:多模态检索 → prompt 构造 → 多模态 LLM 推理与权重归一化。
2.1 预备:线性 CTR 估计器¶
设客户集合 $\mathcal{U}$,$|\mathcal{U}| = N$;广告集合 $\mathcal{R}$,$|\mathcal{R}| = M$。对客户 $u \in \mathcal{U}$ 和广告 $r \in \mathcal{R}$,令 $n$ 维个性化特征向量为 $\xi^u = \left(\xi^u_0, \xi^u_1, \ldots, \xi^u_n\right)$,由历史交互与上下文信号构造;广告 $r$ 的权重向量为 $\theta^r = \left(\theta^r_0, \theta^r_1, \ldots, \theta^r_n\right)$。则该 (u, r) 对的 CTR 预估为
$$p(u, r) = \sigma\!\left((\theta^r)^{\prime}\, \xi^u\right), \qquad \sigma(x) = \left(1 + e^{-x}\right)^{-1} \tag{1}$$
传统有监督设定下,每个 $\theta^r$ 通过在所有用户上最小化 log-loss 学得:
$$\mathcal{L} = -\frac{1}{N} \sum_{u} \left[ y^u_r \log p(u, r) + (1 - y^u_r) \log\{1 - p(u, r)\} \right] \tag{2}$$
其中 $y^u_r$ 是用户 $u$ 是否点击广告 $r$ 的二值标签。
在 LLM-HYPER 中,每个冷广告 $r$ 的权重向量 $\theta^r$ 由 LLM 直接生成:
$$\text{prompt}_{\xi, r} = \left(\text{text}_{\xi},\ \text{img}_r,\ \text{text}_r,\ \text{few-shot}_r\right), \qquad \theta^r = \mathrm{LLM}\!\left(\text{prompt}_{\xi, r}\right) \tag{3}$$
论文明确说明:这个线性模型可推广到复杂深度模型内部的特征聚合层(Liang et al., 2020;Wang et al., 2022)以及跨信号通道的线性校准层(Yan et al., 2022),但本文的范围聚焦在 CTR 预测任务下"LLM 生成线性权重"这一最本质的步骤。
2.2 Prompt 设计:三段式模板¶
prompt 模板由三部分组成(对应 Figure 1 的 (b)(c)(d)):
(a)cot_example——上下文化。广告同时包含丰富的文本信息(标题、文案)和视觉信息(图片)。为了找到有信息量的历史广告,论文用 CLIP(Radford et al., 2021)把广告的图文编码为统一嵌入 $e_i = \mathrm{CLIP}(\text{img}_i, \text{text}_i)$,并基于此建立多模态检索(用 Faiss 做 KNN):
$$\mathrm{KNN}_r = \arg\min_{i \in \mathcal{H},\, |S| = k} \sum_{i \in S} \left\| e_i - e_r \right\| \tag{4}$$
其中 $\mathcal{H}$ 是历史投放集合,$e_r$ 是当前候选冷广告 $r$ 的 CLIP 嵌入。拿到 top-K 索引后,检索出这些暖广告的文本、图片、元信息,以及它们用传统线性方法在历史暖广告数据上训练出来的权重向量,组成 few-shot 示例:
$$\text{few-shot}_r = \left\{ \left(\text{text}_i, \text{img}_i, \theta_i\right) \mid i \in \mathrm{KNN}_r \right\}$$
论文特意把示例与当前候选的相似度分数一并写进 prompt,供 LLM 做知识迁移时加权参考。这是整个方法最关键的设计——LLM 学的不是"怎么推荐",而是"内容相似的广告,其特征权重长什么样"这一映射关系。
(b)task_input——冷广告物料化。写入用户特征的定义($\xi_1$ definition、$\xi_2$ definition……)以及冷广告的文案与图片摘要(image caption 由 LLM 生成)。论文对"为什么要写特征定义"给出了明确动机:因为在服务阶段,用户特征要与生成的权重做数值乘法,而生成阶段是 NLP 推理;把特征定义放进 prompt 是为了缩小"生成阶段(语言推理)"与"服务阶段(数值计算)"之间的上下文 gap。
(c)criteria——生成指导与反思。三条准则:① 依据特征定义识别客户的关键兴趣与偏好;② 分析广告标题与图片摘要以确定相关商品信息;③ 综合相关性与历史示例分数(按内容相似度加权)预测一个分数。并显式约束 分数范围为 $[-1, 1]$,要求 LLM 在预测时考虑该分布。输出格式强制"每个特征一行一个权重"。
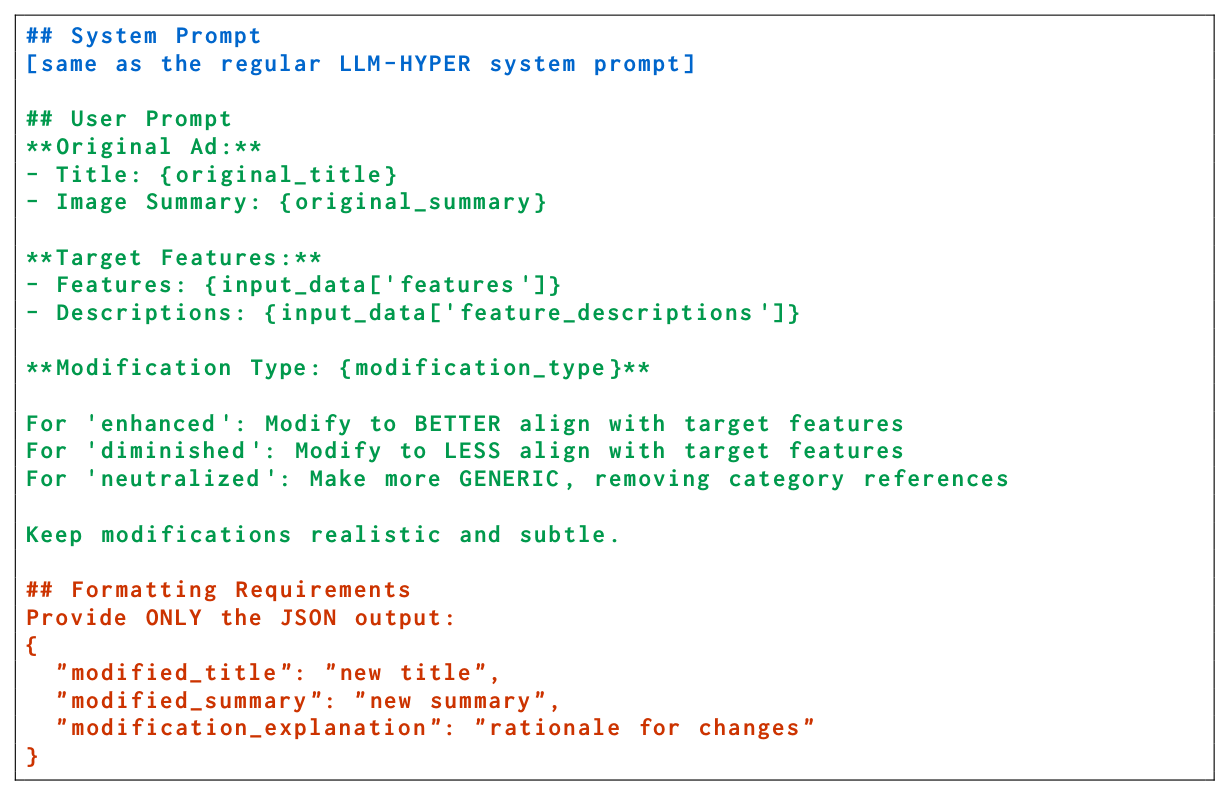
完整 prompt 模板(3-shot、feature batch size = 5)见 Figure 5:
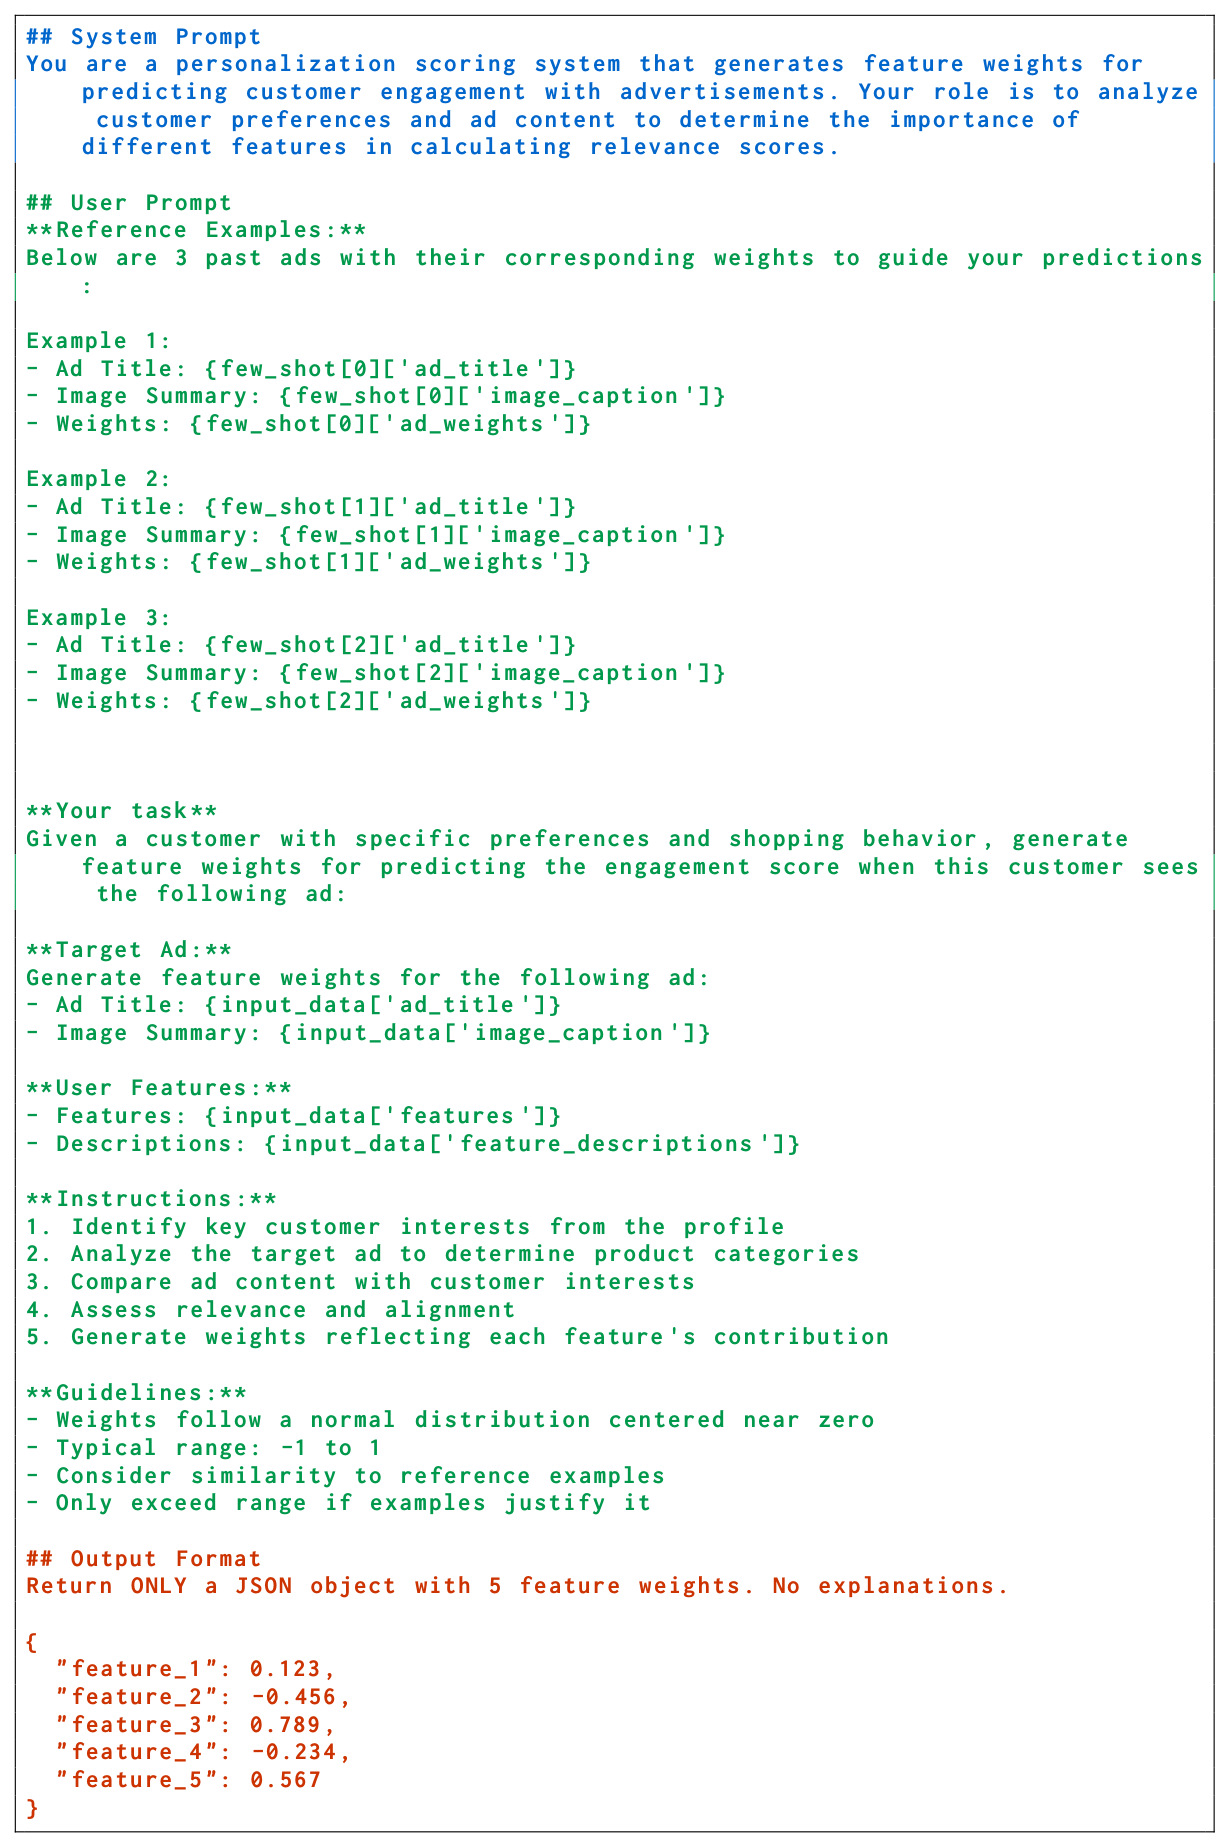
模板里的 Guidelines 进一步写明"权重服从近似零均值的正态分布""典型范围 -1 到 1""只有当示例支持时才可越界",输出为仅含 5 个特征权重的 JSON。Figure 6 给出强调 CoT 的增强版输出格式,要求 LLM 额外产出 ad_analysis / alignment / key_factors / reasoning_summary 四个推理字段再给 predicted_score——这正是后文"一致性率"指标能被计算的前提。
2.3 权重归一化与截距校准¶
LLM 生成的原始权重存在两个可服务性问题:数值尺度不稳定,以及预测概率分布与线上已有模型不对齐。论文用两步解决。
第一步,L2 归一化,抑制过大参数值带来的过拟合风险:
$$\tilde{\theta}^r = \theta^r / \left\| \theta^r \right\| \tag{5}$$
第二步,截距平移校准。对归一化后的权重向量加一个截距偏移 $\delta$,使其预测概率的期望与"相似的已有内容"的平均预估概率 $\alpha$ 对齐:
$$\mathbb{E}\!\left[\sigma\!\left\{(\tilde{\theta}^r)^{\prime} \xi^u + \delta \right\}\right] = \alpha \tag{6}$$
其中 $\alpha$ 取自公式 (4) 检索到的相似可用内容的平均预估概率。$\delta$ 通过数值计算求解:对客户数据做采样,得到 $(\tilde{\theta}^r)^{\prime} \xi^u$ 的分布,再反解使最终输出概率符合期望的正负预测平衡。
这一步的意义在于:校准过程完全不需要标签(label-independent),$\alpha$ 来自相似暖广告的预测分布而非真实点击率。这使得整条链路从生成到上线都不依赖冷广告的任何反馈数据。
2.4 部署架构:把 LLM 推理彻底移出服务链路¶
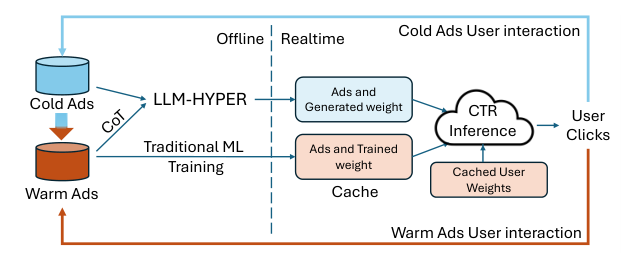
部署逻辑非常清晰地分成 Offline / Realtime 两层:
- Offline:暖广告的用户交互 → 传统 ML 训练 → 得到暖广告的已训练权重;这些权重连同图文内容进入 CoT 示例池。冷广告 $\mathcal{R}_{\text{cold}} = \{r_1, r_2, \ldots\}$ 到来时,LLM-HYPER 在上线日期之前离线生成权重集合 $\Theta = \{\theta_1, \theta_2, \ldots\}$。因为有充足的提前量,LLM 生成耗时(见 §6.3,最长 102.9 秒/广告)完全不构成瓶颈。
- Realtime:生成的权重写入可实时访问的缓存(或服务器),在线排序时只做线性计算。
- 闭环:冷广告上线后逐步"暖化",交互数据积累起来,重新进入传统 ML 训练流程,平台随后切换到暖启动模型做排序推理。
也就是说,LLM-HYPER 的定位是冷启动期的过渡排序器,目标是把冷启动期大幅缩短,而非长期替代暖启动模型。
3. 关键工程细节(Appendix A / C)¶
论文附录里有几处工程经验对复现和落地相当关键:
特征分批(feature batch size)。生成时如何组织用户特征组合是一个真实的 trade-off:一次只让 LLM 生成一个特征的权重,可追踪性最好,但丢失跨特征关联且时间与金钱成本很高;一次给出全部特征定义,则指令遵循能力下降、幻觉风险上升。论文的经验结论是 一次 5 到 10 个特征,在跨特征连通性与可追踪性之间取得平衡。
幻觉与随机性抑制。幻觉会造出不存在的关联,误导权重生成、模拟出错误的用户—广告交互;随机性则影响"重要性处于边界"的特征的稳定性。实践中采取四条措施:① 要求 LLM 同时输出推理与权重,强制自反思;② 用 LLM-as-judge 校验生成结果,发现错误信息后重新生成;③ 在给定预算内多次生成取平均以降低随机性;④ 附录 A 的 mini-batch 式特征-权重预测本身提供了额外上下文,稳定边界特征的生成。
不当内容治理。若冷启动排序器把不合适的广告排给用户(论文举例:把肉类广告推给强素食偏好的用户),既伤指标也伤体验。由于推理与权重都由 LLM-HYPER 产出,可以用同一套 LLM-as-judge 交叉校验"特征定义 vs 广告内容"。注意这里的定位是过滤器而非分数正确性评估:被判定冲突的广告会被打标并从候选中移除(针对该特征取值高的用户)。因为只需按广告校验而非按用户,成本可控。
Prompt 优化。生产中进一步用 DSPy 与 GEPA(Agrawal et al., 2025)对权重生成 prompt 做自动优化,并纳入人工标注反馈与暖启动已训练模型给出的指示。
多模态输入的实现细节。除图片 caption 外,实际可以把图片文件 base64 编码后直接喂给多模态 LLM(论文给出了 LangChain 的 HumanMessage 代码片段),附录明确说这一实践有助于工业环境下的稳健部署。
4. 实验设置¶
4.1 数据集¶
由于是自有数据,细节披露有限,但采样口径写得比较清楚:
- 从美国最大电商平台之一采样 675 个暖广告及其用户交互反馈,覆盖 1,000,000 用户,时间跨度过去 3 个月;
- 为在离线模拟冷启动,先按时间切分:较早的 455 个广告及其已训练权重构成 retired ad set(即 CoT 示例池 $\mathcal{H}$),较新的 120 个广告构成 active ad set;
- active 集再按用户切分:800,000 用户的交互用于训练(供 $\mathrm{LR}_{\text{warm}}$ 上界使用),200,000 用户的交互留作测试。
4.2 Baseline¶
暖启动上界:$\mathrm{LR}_{\text{warm}}$——在 120 个 active 广告的训练集上训练线性 CTR 模型并在测试集评估。这是新广告的理想但在真实冷启动中不可达的情形。
冷启动 baseline 三类:
- EmbT5:经典的基于嵌入的冷启动推荐 baseline。用 Sentence-T5-base(Ni et al., 2022)分别编码用户与广告的 NLP 上下文再算余弦相似度。广告侧上下文由 LLM 从标题与图片 caption 构造,用户侧上下文由 LLM 总结用户历史广告交互得到。
- LLM-R(Hou et al., 2024a,"LLMs are zero-shot rankers")与 LLM-TR(Zhang et al., 2025,LLMTreeRec):LLM 推荐器 baseline,直接依据用户与广告的 NLP 上下文对广告排序。
- $\mathrm{LR}_{\text{cold}}$:面向低延迟需求的启发式 baseline——权重取 455 个 retired 广告权重的中位数(用中位数而非均值以抑制离群广告影响)。
所有 baseline 都按各自论文报告的配置与参数实现。
4.3 LLM-HYPER 变体与超参¶
按所用 LLM 骨干区分四个变体:LH2.5P(Gemini-2.5-Pro)、LH2.5F(Gemini-2.5-Flash)、LH4o(GPT-4o)、LH5.1(GPT-5.1)。所有变体统一用 5-shot CoT、temperature = 0.5。
4.4 评测指标¶
离线排序报告 AUC 与 NDCG@{5, 10};线上 A/B 报告相对 CTR 分数;服务效率报告 120 个 active 广告上 CTR 预测的平均延迟 $L$(毫秒)。所有 LLM-HYPER 变体的权重生成均在计算 CTR 与评测延迟之前离线完成。
5. 主要实验结果¶
5.1 离线冷启动排序对比(RQ1)¶
Table 1: Offline Cold-start Ranking Comparison
| Model | AUC | NDCG@5 | NDCG@10 | L (ms) |
|---|---|---|---|---|
| EmbT5 | 0.4105 | 0.0174 | 0.0262 | 0.357 |
| LLM-R | 0.0571 | 0.00931 | 0.0221 | 2.13E3 |
| LLM-TR | 0.0576 | 0.00886 | 0.0508 | 3.78E3 |
| LH4o | 0.6539 | 0.0490 | 0.0764 | 0.163 |
| LH5.1 | 0.6497 | 0.0427 | 0.0668 | 0.158 |
| LH2.5F | 0.6654 | 0.0435 | 0.0779 | 0.160 |
| LH2.5P | 0.6722 | 0.0456 | 0.0792 | 0.157 |
| LRcold | 0.5593 | 0.0328 | 0.0508 | 0.147 |
| LRwarm(上界) | 0.7005 | 0.0639 | 0.0871 | 0.151 |
结论分析:
- 所有 LLM-HYPER 变体都显著优于其他冷启动 baseline(p-value ≤ 0.05)。最佳变体 LH2.5P 相对最强冷启动 baseline $\mathrm{LR}_{\text{cold}}$ 取得 AUC +20.2%(0.5593 → 0.6722)与 NDCG@10 +55.9%(0.0508 → 0.0792),并把与暖启动上界的 AUC 差距压缩到 0.6722 vs 0.7005(约 96% 的相对水平)。
- EmbT5 在严格冷启动下表现很差(AUC 0.4105,低于随机猜测)。论文归因于"离线广告相关性"与"在线用户反馈"之间存在巨大的上下文 gap(Song et al., 2024)——语义上最相关不等于用户会点。LLM-HYPER 通过 LLM 推理跨越了这个 gap,因为它拟合的目标不是语义相似度,而是暖广告实测学出来的权重分布。
- LLM-R 与 LLM-TR 是全场最差(AUC 0.0571 / 0.0576)。论文归因于幻觉与分布外预测(Jiang et al., 2025):这两个 LLM 推荐器可能生成不存在的广告名或索引却无后续纠正机制,还会把零交互的"过于新颖"的广告排到头部。LLM-HYPER 因为直接生成权重再归一化,绕开了"生成物品名"这一环,几乎不存在广告名幻觉问题。这实际上是本文最有说服力的论证之一:同样用 LLM,输出"参数"比输出"物品"在工业排序里稳健得多。
- 一个值得注意的非单调现象:LH4o 的 NDCG@5 反而最高(0.0490 > LH2.5P 的 0.0456),但 AUC 与 NDCG@10 都落后。说明不同骨干在"头部精排"与"整体序质量"上的强项并不一致,论文未对此展开。
5.2 延迟(RQ1)¶
所有 LLM-HYPER 变体的平均延迟落在 (0.14, 0.17) 毫秒区间,与线性 baseline 同级(LRcold 0.147 ms、LRwarm 0.151 ms)。原因正是把昂贵的 LLM 推理与服务阶段解耦,在线只做线性计算。相比之下 LLM 推荐器 baseline 需要 2.13E3 / 3.78E3 毫秒(即 2.1 秒 / 3.8 秒),慢了约四个数量级;LLM-TR 靠额外的层次化 LLM 调用换来了比 LLM-R 更好的效果,代价是延迟进一步上升。EmbT5 的 0.357 ms 虽然也算快,但仍是 LLM-HYPER 的两倍多。
5.3 消融:CoT 示例数与视觉特征(RQ2)¶
在最佳变体 LH2.5P 上,变动 few-shot 示例数量并考察移除图片信息($-\text{img}$)的影响:
Table 2: CoT and Visual Feature Impact
| Models | NDCG@5 | NDCG@10 |
|---|---|---|
| LH2.5P, zero-shot | 0.0376 | 0.0677 |
| LH2.5P, zero-shot, −img | 0.0165 | 0.0352 |
| LH2.5P, 3-shot | 0.0421 | 0.0798 |
| LH2.5P, 3-shot, −img | 0.0267 | 0.0511 |
| LH2.5P, 5-shot | 0.0456 | 0.0792 |
| LH2.5P, 5-shot, −img | 0.0292 | 0.0506 |
结论分析:
- 即使零样本也已超越最强冷启动 baseline:zero-shot NDCG@10 = 0.0677 相对 LRcold 的 0.0508 提升 33.3%。这说明 LLM 仅凭"特征定义 + 广告图文 + 分数范围约束"就能推理出可用的权重分布,具备很强的跨模态泛化能力,示例并非必需品。
- 示例数量的边际收益递减且非单调:5-shot 在整体排序指标上最均衡(NDCG@5 最高),但 3-shot 在 NDCG@10 上略占优(0.0798 vs 0.0792)。论文的解读是——适量的高质量示例就足以让模型学会权重分布的逻辑,再多反而无益。
- 视觉特征是刚需:移除图片后所有配置都大幅退化,且退化幅度随示例数增加而扩大——zero-shot 从 0.0677 掉到 0.0352(−48%),3-shot 从 0.0798 掉到 0.0511(−36%),5-shot 从 0.0792 掉到 0.0506(−36%)。更关键的是,所有 $-\text{img}$ 配置都跌回甚至跌破 LRcold 的 0.0508 水平,意味着去掉视觉信息后 LLM-HYPER 相对启发式基线的优势基本消失。广告是图文并茂的媒介,只看标题不足以判断内容—用户兴趣的匹配关系。
5.4 可解释性评估(RQ3)¶
高风险广告环境下,绕过训练直接生成权重必须回答一个问题:这些权重是不是可信的特征重要性?
人工标注数据集:请市场营销专家为测试集中每条广告标注"最重要的用户特征"(可为一个或多个),作为特征重要性的 ground truth。
三个指标(附录 B):
$$\mathrm{HR@5} = \frac{1}{M} \sum_{i=1}^{M} \mathbb{I}\!\left(P_{gt,i} \in P_{top5,i}\right) \tag{7}$$
其中 $P_{gt,i}$ 是第 $i$ 条广告的目标特征,$P_{top5,i}$ 是按生成权重降序排列的 top-5 特征集合,$M$ 为评测广告总数,$\mathbb{I}(\cdot)$ 为指示函数。
$$\mathrm{Coverage@5} = \frac{1}{M} \sum_{i=1}^{M} \frac{\left|P_{top5,i} \cap P_{gt,i}\right|}{\left|P_{top5,i} \cup P_{gt,i}\right|} \tag{8}$$
这是一个基于 Jaccard / IoU 的覆盖度量,用于一条广告对应多个 ground-truth 特征的情形;当 $P_{gt,i}$ 只含单个目标特征时,它反映的是 LLM 高置信对齐的精度。
$$\mathrm{Consistency\ Rate} = \frac{1}{M} \sum_{i=1}^{M} \mathbb{I}\!\left(\mathrm{sign}(R_i) = \mathrm{sign}(S_i)\right) \tag{9}$$
一致性率衡量 LLM 的自然语言推理 $R_i$ 与其数值权重 $S_i$ 之间的逻辑一致性,采用符号一致性(Sign Agreement):由辅助的 LLM-Judge(实际用 Gemini-2.5-Pro)把推理文本映射为情感极性 $\mathrm{sign}(R_i) \in \{\text{positive}, \text{neutral}, \text{negative}\}$,预测分数 $S_i$ 则按其相对 0 的标量值映射。
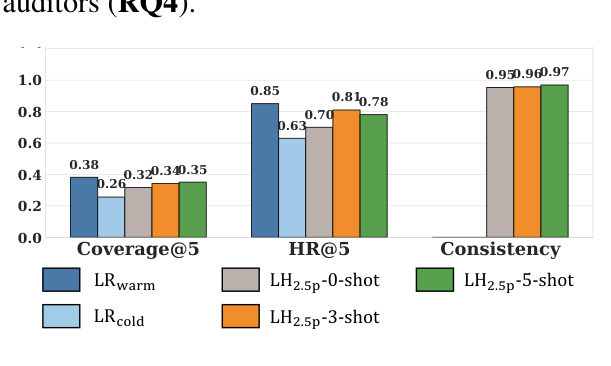
Figure 3 数值汇总:
| 指标 | LRwarm | LRcold | LH2.5P 0-shot | LH2.5P 3-shot | LH2.5P 5-shot |
|---|---|---|---|---|---|
| Coverage@5 | 0.38 | 0.26 | 0.32 | 0.34 | 0.35 |
| HR@5 | 0.85 | 0.63 | 0.70 | 0.81 | 0.78 |
| Consistency | — | — | 0.95 | 0.96 | 0.97 |
结论分析:
- 示例数量直接增强与目标特征的对齐:Coverage@5 从 zero-shot 的 0.317 提升到 5-shot 的 0.351(图中标注为 0.32 → 0.35),HR@5 在 3-shot 达到峰值 0.81。论文的解读是 CoT 示例充当了语义锚点,帮助 LLM 把预测权重准确落到目标特征上。
- LLM-HYPER 的可解释性介于两个线性基线之间:全面优于冷启动启发式 $\mathrm{LR}_{\text{cold}}$(HR@5 0.63、Coverage 0.26),但仍未追上有真实标签训练的 $\mathrm{LR}_{\text{warm}}$(HR@5 0.85、Coverage 0.38)。这与排序指标的结论一致——免训练能逼近但尚未达到有标签训练的上界。
- 一致性率在所有设置下都稳定在 0.95 以上(0.95 / 0.96 / 0.97),说明生成的权重确实扎根于显式的、人类可读的推理,而不是与推理脱节的随机数。这是满足工业透明度要求的关键证据:权重的尺度忠实反映了推理阶段识别出的偏好。
5.5 反事实鲁棒性(RQ4)¶
在真实标签不可得的情况下,广告排序必须对语义扰动与对抗性修改保持稳健。论文设计了反事实实验,对广告标题与摘要施加三类由辅助 LLM 生成、且以人工标注的目标特征为条件的语义修改:
- Enhanced:改写广告以强化与目标特征的对齐(例:增加更多关于狗的信息);
- Diminished:改写广告使其与目标特征冲突/偏离(例:从狗切换到猫);
- Neutralized:中性化目标特征线索,变成泛化描述(例:从狗改为"宠物")。
评测指标:权重方向准确率。设 $S_{\text{orig}}$ 为原广告的权重、$S_{cf}$ 为反事实广告的权重,对修改类型 $m \in \{\text{Enhanced}, \text{Diminished}, \text{Neutralized}\}$,第 $i$ 个样本的二分类预测在权重变化方向与修改语义意图一致时判为正确:
$$D(i, m) = \begin{cases} 1 & \text{if } (m = \text{Enhanced} \wedge S_{cf} > S_{\text{orig}}) \vee (m = \text{Diminished} \wedge S_{cf} < S_{\text{orig}}) \vee (m = \text{Neutralized} \wedge |S_{cf}| < |S_{\text{orig}}|) \\ 0 & \text{otherwise} \end{cases} \tag{10}$$
$$\mathrm{Accuracy} = \frac{1}{N} \sum_{i=1}^{N} D(i, m) \tag{11}$$
其中 $N$ 为反事实样本总数。
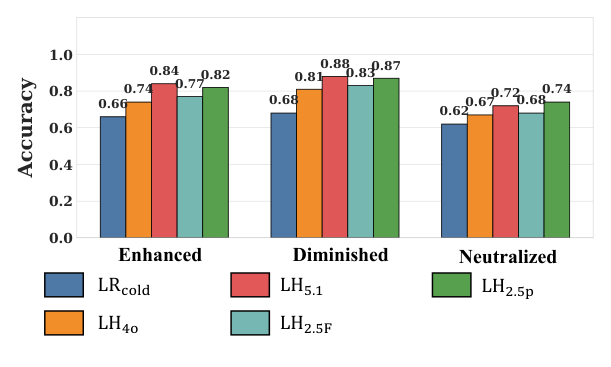
Figure 4 数值汇总(Accuracy):
| 修改类型 | LRcold | LH4o | LH5.1 | LH2.5F | LH2.5P |
|---|---|---|---|---|---|
| Enhanced | 0.66 | 0.74 | 0.84 | 0.77 | 0.82 |
| Diminished | 0.68 | 0.81 | 0.88 | 0.83 | 0.87 |
| Neutralized | 0.62 | 0.67 | 0.72 | 0.68 | 0.74 |
结论分析:
- GPT-5.1(LH5.1)在 Diminished 设定下达到 0.88 的最高准确率,展现出较强的上下文推理能力,能有效惩罚偏离目标特征的权重。有意思的是,排序指标上最强的 LH2.5P 在鲁棒性上并非全面最优(Enhanced 0.82 < LH5.1 0.84,Diminished 0.87 < 0.88),仅在最难的 Neutralized 上以 0.74 领先——说明"排序精度"与"语义方向一致性"是两个可分离的能力维度。
- 所有骨干在 Neutralized 类别上都明显下滑(0.67–0.74 vs Diminished 的 0.81–0.88)。这符合直觉:把"狗"改成"宠物"是弱化而非反转语义,要求模型判断权重绝对值是否缩小,比判断符号方向难得多。
- 全部 LLM-HYPER 变体在三类扰动上都优于 $\mathrm{LR}_{\text{cold}}$(0.62–0.68),证明其权重调整确实由语义驱动而非固定先验。论文强调这一能力对工业部署至关重要:系统可以通过"推理—权重一致性"而非依赖历史交互数据来反映偏好变化,同时对人工审计保持完全可解释。
反事实样例(Table 6):
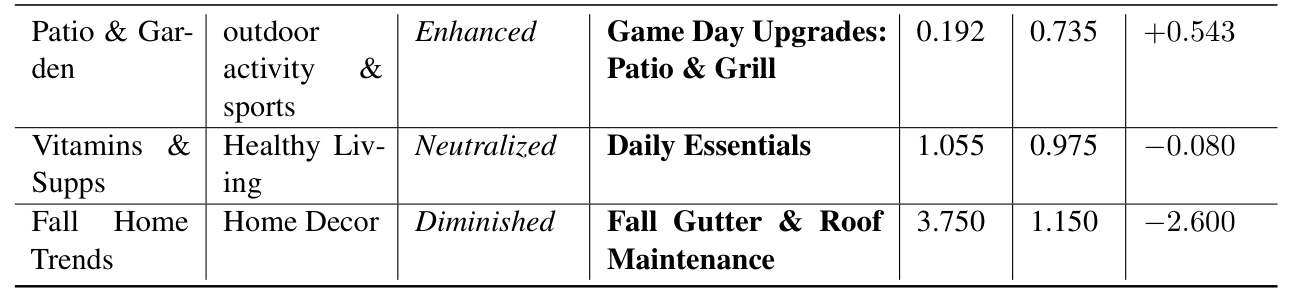
| 原广告 | 目标特征 | 修改类型 | 修改后广告 | $S_{\text{orig}}$ | $S_{cf}$ | $\Delta$ |
|---|---|---|---|---|---|---|
| Patio & Garden | outdoor activity & sports | Enhanced | Game Day Upgrades: Patio & Grill | 0.192 | 0.735 | +0.543 |
| Vitamins & Supps | Healthy Living | Neutralized | Daily Essentials | 1.055 | 0.975 | −0.080 |
| Fall Home Trends | Home Decor | Diminished | Fall Gutter & Roof Maintenance | 3.750 | 1.150 | −2.600 |
三个案例的推理链(附录 E.4)显示 LLM-HYPER 不是在做关键词统计:Enhanced 案例中模型识别出 "Grill" 与 "Game Day" 是"社交型体育聚会"兴趣的高亲和特征;Neutralized 案例中模型明确指出"健康专属效用"与"医药级品牌背书"的丢失,因此权重向中性回落;Diminished 案例中模型指出"屋檐排水沟与屋顶维护"属于室外结构性劳作,缺乏 Home Decor 特征期待的装饰性吸引力,因而给出剧烈惩罚。
6. 补充分析¶
6.1 生成权重的可视化(附录 D)¶
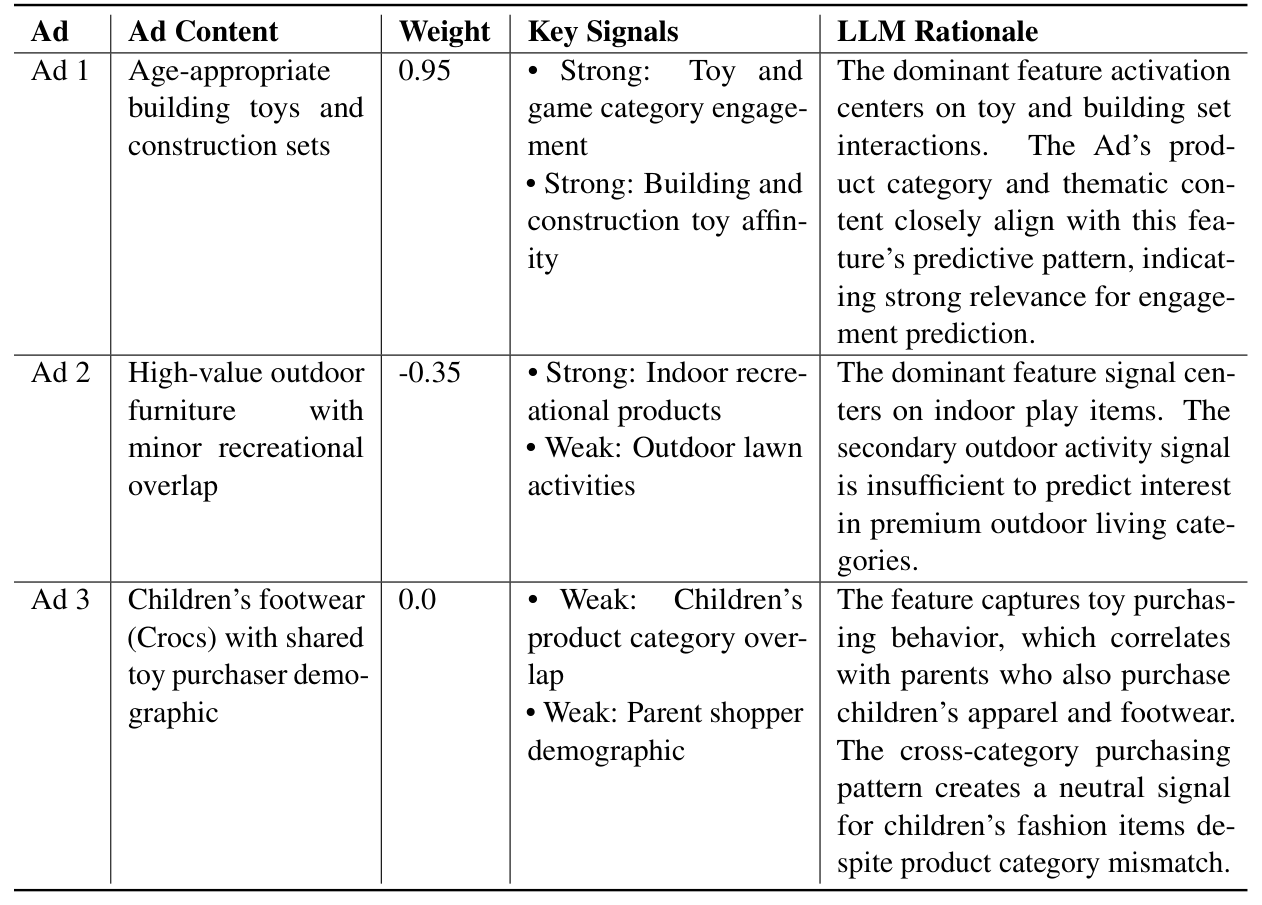
以 feature_toys_games("客户对玩具、游戏与拼图类目的互动度")为例,同一特征在三种广告语境下的权重:
| 广告 | 广告内容 | 权重 | LLM 理由要点 |
|---|---|---|---|
| Ad 1 | 适龄积木与建构玩具套装 | 0.95 | 玩具与建构玩具品类互动信号强,主导性特征激活,与该特征的预测模式高度对齐 |
| Ad 2 | 高价值户外家具(含少量休闲重叠) | −0.35 | 主导信号集中在室内玩乐用品;次级的户外活动信号不足以预测对高端户外生活品类的兴趣 |
| Ad 3 | 儿童鞋类(Crocs),与玩具购买者人群重叠 | 0.0 | 该特征刻画玩具购买行为,与"同时购买童装童鞋的家长"相关;跨品类购买模式在品类不匹配时产生中性信号 |
这组例子直观说明 LLM-HYPER 能把 LLM 的推理能力翻译成线性模型权重,用于模拟用户—广告交互,并且能正确处理"强正相关 / 冲突 / 弱相关"三种关系。
6.2 离线生成耗时与成本权衡(附录 A)¶
Table 4: Offline LLM weight generation time(按广告平均)
| Models | Generation Time (s) |
|---|---|
| GPT-4o | 47.7 |
| GPT-5.1 | 58.7 |
| Gemini-2.5-Flash | 83.3 |
| Gemini-2.5-Pro | 102.9 |
结合 Table 1 可以看出一条清晰的权衡:Gemini-2.5-Pro 排序效果最好但离线生成耗时最长(102.9 秒/广告),虽然离线耗时不影响在线服务,但 Pro 版本比轻量的 Flash 更贵。而 LH2.5F 的 AUC 0.6654 / NDCG@10 0.0779 已经非常接近 LH2.5P 的 0.6722 / 0.0792,生成耗时却缩短 19%。这为后端 LLM 选型提供了明确的"总体 LLM 用量 vs 服务效果"的调节旋钮。
值得注意的是,生成耗时的排序与排序效果的排序并不一致:GPT-4o 最快(47.7s)但 AUC 只有 0.6539,Gemini-2.5-Flash 耗时高于两个 GPT 模型却效果更好,说明"更慢 = 更好"并不成立,选型必须实测。
6.3 线上 A/B 测试与生产部署¶
论文在首页广告排序上做了 30 天的端到端工业级 A/B 测试。对照组为 $\mathrm{LR}_{\text{warm}}$(用预先收集的用户反馈在 A/B 之前训练完成),实验组使用 LLM-HYPER 生成的权重。为构造严格冷启动,active 广告对实验组不做曝光(即实验组从未见过这批广告的任何反馈)。
Table 3: Online 30-Day A/B Test Results
| Models | Relative CTR score |
|---|---|
| LLM-HYPER | 92% |
| LRwarm | 100% |
结论分析:LLM-HYPER 在完全无标签的严格冷启动下达到暖启动理想模型 92% 的相对 CTR,且统计上无显著差异(p-value = 0.62)。这个结果的意义不在于"打败"暖启动模型——那是不可能也非目标——而在于证明:在冷启动期用 LLM 生成的权重排序,与"假装已经有了 30 天数据"的模型效果相当,从而把冷启动期大幅缩短。论文明确说明 LLM-HYPER 已成功部署到生产环境,为首页广告冷启动排序提供服务。
需要客观指出的是,这里的统计解读存在方向性问题:p = 0.62 只说明"没有检测到差异",并不等价于"证明了等价性"(后者需要等效性检验 TOST 之类)。在 30 天、单一场景的样本量下,8% 的相对 CTR 差距未达显著,也可能只是检验功效不足。
7. 核心贡献总结¶
- 范式贡献:首次把 LLM 定位为免训练超网络,直接生成下游 CTR 排序器的参数,而非生成推荐结果。这与既有超网络工作(Ha et al., 2016 至 MetaDiff、扩散式权重生成)的根本区别是彻底摆脱了对训练数据的依赖,因而适用于严格冷启动。
- 知识迁移机制:用 CLIP 多模态检索找到内容相似的暖广告,把它们的已训练权重作为 CoT few-shot 示例并附带相似度分数,让 LLM 学习"内容 → 权重分布"的映射,而非"内容 → 语义相似度"。这正是它超越 EmbT5 一类嵌入相似度方法的根本原因。
- 可服务性机制:L2 归一化 + 不依赖标签的截距校准,把生成权重的预测分布对齐到线上已有模型,使其可直接接入生产服务。
- 部署范式:离线生成 → 缓存 → 在线只做线性点积,把 LLM 推理彻底移出微秒级服务路径,实现 0.157 ms 的服务延迟(比 LLM 推荐器快约四个数量级)。
- 可信度验证:用人工标注的特征重要性数据集验证可解释性(HR@5 0.81、Consistency > 0.95),用反事实扰动验证鲁棒性(Diminished 准确率 0.88),这两项在冷启动无标签场景下是唯一可行的质量把关手段。
- 工业落地:30 天线上 A/B 达到暖启动模型 92% 的相对 CTR(p = 0.62),已在美国头部电商平台生产部署。
8. 与已归档相关工作的对比¶
IDProxy IDProxy: 多模态 LLM 为冷启动物品生成代理 ID Embedding(Xiaohongshu / SJTU / Fudan,2026-03-02)¶
关系:独立并发(IDProxy 早于本文 42 天发表,但本文参考文献中未引用任何 2026 年 arXiv 工作,两者殊途同归)· 已加载对方精读
- 共同关注的问题:两篇论文指向完全相同的 root cause——工业 CTR 排序器中,物品侧那部分"靠交互数据学出来的参数"(IDProxy 指 item ID embedding,本文指广告的线性权重向量 $\theta^r$)在新物品上是空的或训练不充分,而重训练需要交互积累,冷启动期无法等待。两者也都受同一约束:必须无缝接入既有生产 CTR 排序流水线,不能推倒重来。
- 相近的技术骨架:两者的方法流程图可以高度抽象重合——「多模态大模型读取物品图文内容 → 在暖物品上建立"内容 → 已学参数"的对应关系 → 为冷物品离线生成缺失的那份参数 → 写入线上存储/缓存 → 排序阶段像读普通参数一样读它」。两者也都对暖物品参数做 $\ell_2$ 归一化以消除热度带来的幅度偏差(IDProxy 的 $\mathbf{e}_i = \mathbf{e}_i^{\text{raw}}/\|\mathbf{e}_i^{\text{raw}}\|_2$,本文的公式 (5)),且都强调 MLLM/LLM 的语义能力必须被"对齐"到协同空间才可用。
- 本文的差异与推进:最关键的分歧在于如何建立"内容 → 参数"的映射。IDProxy 走的是训练路线:Stage 1 用对比损失 $\mathcal{L}_{\text{PAL}}$ 把 MLLM 隐状态投影拉向真实 ID embedding,Stage 2 再把多层隐状态经残差门控适配器与 CTR 模型端到端联合训练(MLLM 冻结)。本文走的是免训练的 in-context 路线:把暖广告的已训练权重直接塞进 prompt 当 few-shot 示例,靠 LLM 的上下文推理一次性吐出权重,全程零梯度更新。代价与收益是对称的——IDProxy 因为端到端训练,能吃到 CTR 模型不断演化的结构先验,但每次都需要暖数据与训练资源;本文完全不需要任何训练环节,新广告到来即可生成,但目标网络被限死为线性形式。第二个差异是生成对象的可解释性:IDProxy 产出的是稠密 proxy embedding(不可读),本文产出的是逐特征线性系数(可读、可审计),因此本文能做人工标注的特征重要性评估与反事实方向性检验,IDProxy 无法做这类验证。第三个差异是评估口径:IDProxy 报告的是相对生产基线的 ΔAUC(Stage 1 +0.05% 量级)并在小红书内容推荐与展示广告双场景上线;本文报告的是绝对 AUC 与 NDCG,并以暖启动模型为参照上界。
- 可比的方法/实验差异:两者都只在自有工业数据上评测,无公开数据集,因此不可直接比数。方法层面一个有意思的互补点是:IDProxy 明确指出"工业 ID embedding 分布不规则、非聚类化,浅层 MLP 映射难以桥接语义与协同空间",因而需要两阶段粗到细;本文之所以能用更简单的 in-context 方式绕过这个难题,恰恰是因为它的目标参数是线性层的逐特征系数——每一维都有明确的语义(对应一个人类可读的特征定义),可以用自然语言直接描述并让 LLM 推理,而 ID embedding 的每一维没有语义、无法写进 prompt。这暗示"LLM 当超网络"这条路的适用边界:目标参数的每一维必须可语义化命名。
GenRecEdit GenRecEdit: 用模型编辑解决生成式推荐的冷启动崩塌(Renmin University of China / UIBE,2026-03-15)¶
关系:独立并发(GenRecEdit 早于本文 29 天发表,本文未引用)· 已加载对方精读
- 共同关注的问题:两者都把冷启动重新表述为"模型参数里缺了这个物品的那一块",并且都拒绝"等交互数据积累后重训练"这一默认解法——GenRecEdit 列出的三条理由(反馈稀疏、重训练计算成本高、更新延迟在新闻/短视频等实时场景不可接受)与本文的促销档期切换场景是同一类痛点。两者也都明确绕开梯度式的完整训练。
- 相近的技术骨架:抽象流程惊人地一致——「用内容编码器把冷物品编码 → 检索内容最相似的暖物品 → 借用这些暖物品身上"已经学好的东西" → 直接写进模型参数,不做完整重训练」。GenRecEdit 用 Sentence-T5 编码物品元数据并按余弦相似度取 TopK 暖物品($\mathcal{N}_k(c)$),本文用 CLIP 编码图文并做 Faiss KNN(公式 (4));GenRecEdit 借的是暖物品对应用户的真实交互历史(构造伪交互序列),本文借的是暖广告的已训练权重向量本身。
- 本文的差异与推进:分歧在于"直接写参数"的技术手段。GenRecEdit 沿用 NLP 的 locate-then-edit 范式:先用 probing classifier 定位关键编辑层,再对每个编辑请求求解干预量 $\delta_i$,最后用闭式最小二乘解 $\Delta W = R K_1^{\top}(\lambda C_0 + K_1 K_1^{\top})^{-1}$ 更新 FFN 的 $W_{\text{out}}$——虽然免于完整重训练,但仍然要跑优化(论文报告需 9.5% 的重训练时间),并且仍需要伪标签(借来的交互序列)。本文则完全没有任何优化过程:权重由 LLM 前向推理一次生成,只需 L2 归一化与数值求解截距 $\delta$。第二个差异是编辑对象:GenRecEdit 修改的是已训练好的生成式推荐模型内部的 FFN 权重,属于"改造存量模型";本文是从零合成一个全新的、专属于该冷广告的排序器,属于"凭空造增量模型",两者对既有系统的侵入性完全不同(GenRecEdit 改动主干模型,本文只往缓存里写一行)。第三个差异是验证维度:GenRecEdit 在 Amazon Phone/Video/Software 三个公开数据集上做学术评测并诊断出"冷启动崩塌"(cold item NDCG@10 下降 85%–88%);本文只有自有数据,但补上了线上 A/B 与生产部署,以及 GenRecEdit 没有的可解释性与反事实鲁棒性检验。
- 可比的方法/实验差异:GenRecEdit 面向的是生成式推荐(SID 自回归),冷启动崩塌的机制是"模型几乎不生成冷物品的 SID 模式";本文面向的是判别式 CTR 排序,冷启动的机制是"没有权重可用"。两者不可直接比数,但把它们并排看能得到一个更一般的结论:在冷启动这件事上,2026 年上半年出现了一条共同的方法论转向——从"想办法给冷物品造标签然后训练"转向"想办法直接把参数写出来"。GenRecEdit 用的是模型编辑的闭式解,IDProxy 用的是对比对齐训练出的生成器,本文用的是 LLM 的 in-context 推理,三者在"直接产参数"这个抽象层面同构,在"要不要训练、训练多少"这一维上恰好排成一条从重到轻的谱系,而本文位于最轻的一端。
9. 讨论与局限性¶
9.1 值得借鉴的设计¶
- "让 LLM 输出参数而非输出物品"这一转向本身就是主要贡献。Table 1 里 LLM-R/LLM-TR 的 AUC 只有 0.057——比随机还差一个数量级——而同样的 LLM 骨干在 LLM-HYPER 框架下能达到 0.67。差别不在模型能力,而在输出空间的选择:让 LLM 生成物品名/索引,就要承担幻觉与分布外的全部风险;让 LLM 生成一组有明确语义的实数系数,再由归一化与校准兜底,幻觉的破坏面被压缩到最小。这个思路可以外推到很多"想用 LLM 但受不了延迟与幻觉"的工业场景。
- 把"生成阶段"与"服务阶段"的上下文 gap 显式写进 prompt。论文特意把用户特征定义放进 prompt,理由是生成阶段是语言推理、服务阶段是数值乘法,两者语境不同。这是一个很实在的工程直觉。
- 不依赖标签的校准。$\alpha$ 取自检索到的相似暖内容的平均预估概率而非真实 CTR,使整条链路在冷启动下自洽,不留"其实还是偷偷用了标签"的后门。
- 可解释性与鲁棒性作为无标签场景的替代验收标准。当没有 ground-truth 点击可用时,"推理—权重符号一致性"和"语义扰动—权重方向一致性"提供了两条可操作的质量门禁,这套评测设计本身值得复用。
9.2 局限性与争议¶
- 目标网络被限死为线性模型,方法论可扩展性存疑。这是最根本的限制。论文虽然声称该线性模型"可推广到复杂深度模型内部的特征聚合层与线性校准层",但明确把这些留在了范围之外,没有任何实验支撑。参数量 scaling 时,LLM-HYPER 无法同步扩充"表征能力"——目标网络永远是 $n$ 维线性层。更进一步,"离线生成 + 缓存"的硬解耦意味着生成器(LLM)与下游排序器无法端到端联合优化,这正是典型的两阶段解耦瓶颈。方法的天花板由线性形式和 LLM 的零样本推理质量共同决定,两者都不随投入线性增长。
- 实验规模偏小且完全不可复现。675 个广告(455 retired + 120 active)、单一首页广告场景、全部为专有数据,无任何公开数据集实验。NDCG 绝对值也很低(最好 0.0792),+55.9% 的相对提升是在 0.0508 这一低基数上取得的,绝对增益仅 0.028。
- 冷启动 baseline 覆盖不全。对比对象是 EmbT5、两个 LLM 推荐器、以及一个中位数权重启发式。但没有对比该领域的主流冷启动方法——引言与相关工作里详细列举的 MeLU、MAMO、MetaEmbedding 等元学习路线,以及 CB2CF/CLCRec 这类内容—协同映射方法,一个都没有进入实验表。$\mathrm{LR}_{\text{cold}}$(取 455 个退役广告权重的中位数)是一个相当弱的对照,AUC 仅 0.5593。
- 线上收益的披露方式偏保守且统计解读有瑕疵。只给了 92% vs 100% 的相对 CTR 与 p = 0.62,没有绝对量级、没有置信区间,也没有"冷启动期缩短了多少天"的量化——而这恰恰是摘要里 "drastically reduces the cold-start period" 的核心卖点。如前所述,p = 0.62 不能作为等价性的证据。
- prompt 约束与实际输出不自洽。criteria 与 Guidelines 都明确要求权重落在 $[-1, 1]$("只有示例支持时才可越界"),但 Table 6 里出现了 $S_{\text{orig}} = 3.750$、$1.055$ 这样明显越界的值。虽然后续有 L2 归一化兜底,但这说明 LLM 对数值范围约束的遵循并不可靠,也间接印证了归一化步骤的必要性。
- 多次生成取平均、LLM-as-judge 校验、DSPy/GEPA prompt 优化等关键实践只出现在附录,且没有消融。这些措施对最终效果的贡献未知,Table 1 的数字究竟对应哪一档工程加持并不清楚,复现难度进一步加大。
- 成本核算缺失。附录只给了单条广告的生成耗时(47.7–102.9 秒),没有给 token 消耗与实际金钱成本。在广告量级大、上新频繁的平台上,"每条新广告调用一次 Gemini-2.5-Pro 且多次生成取平均"的总成本是决定该方案能否推广的关键变量。
- 只覆盖冷启动期,未讨论切换时机。系统设计上冷广告暖化后要切回传统模型,但论文没有讨论何时切换、切换是否平滑、以及 LLM 生成的权重与后续训练出的权重之间是否存在分布跳变导致的线上抖动。
9.3 工业落地价值¶
论文的工业价值集中在部署形态而非模型精度:它给出了一套在不改动线上服务架构的前提下引入 LLM 能力的完整配方——离线生成、缓存下发、线性服务、LLM-as-judge 做内容合规过滤、DSPy/GEPA 做 prompt 迭代。0.157 ms 的服务延迟与线性 baseline 无差别,意味着接入成本几乎为零。对于任何已有线性打分层或线性校准层的工业排序系统,这套方案都可以作为冷启动期的插件式补丁引入,风险可控且可随时回退(切回中位数权重或暖启动模型)。这也是它能在美国头部电商平台真正上线并长期运行的原因。