Connected Content Retriever:用稠密图边特征驱动 LinkedIn 的粗排
arXiv 2609.22441 · LinkedIn Corporation · 2026-09-18(v1) 论文 PDF 标题为 Connected Content Retriever: Dense Graph Edge Features for Pre-Ranking at LinkedIn,arXiv 页面标题为 "...Powering Pre-Ranking at LinkedIn"。
一、研究动机与背景
1.1 业务场景:图驱动的 Feed 分发
LinkedIn Feed 中来自成员自身网络(connections 与 follows)的内容——作者称为 Connected Content(CC)——占据了 70% 以上的曝光与互动。与全局热度驱动的内容平台不同,LinkedIn 的分发本质上是图介导(graph-mediated)的:大部分 Feed 曝光是由观看者(viewer)网络邻域内的实体创作或参与过的活动(activity)。其中包括两类:
- 一度网络内容:一度好友或关注对象创作的帖子;
- 二度传播内容(stranger viral):一度好友点赞 / 评论 / 转发但并非其创作的帖子。
由于这种扇出,候选索引规模超过十亿;按 viewer 的网络筛选后,每个请求仍剩数万条活动,需要在 120 ms p99 的延迟预算内打分,并把最好的几百条交给下游精排(L2)。
论文的关键判断是:一条候选帖子的相关性由两部分共同决定——(i) 其语义内容;(ii) viewer 与内容作者之间沿社交图的亲密度,作者称为 connection strength,并主张把它作为与话题兴趣同等地位的一等排序特征,而不是像以往那样只当作图距离先验或事后重加权。论文中"author"泛指发起该候选 activity 的成员——无论是原创、转发、点赞还是评论。
1.2 为什么 CC 与"非连接内容"不同
作者团队此前的工作 [9](LinkedIn Feed 的因果语言模型大规模检索)表明,LLM 驱动的因果检索在非连接内容上可以有效扩展,因为那里相关性主要由内容语义主导。但 CC 场景性质不同:viewer–author 成对边特征(tie strength、互动新近度、共同参与、二度路径统计)携带一阶信号,无法仅从内容 embedding 中恢复。作者声称:在线 A/B 中,若 CC 粗排层仅由 LLM 内容 embedding 驱动、不做图边条件化,线上互动指标出现统计显著的下降(但正文未给出该 A/B 的具体数值,只在离线消融中量化边特征的贡献)。
1.3 核心瓶颈:CPU 算力包络
粗排层的主导约束是算力:每请求对数万候选打分、p99 ≤ 120 ms。历史上这把 CC 粗排器压在低容量区间——典型是浅层 MLP 或双塔,约 $O(10^5)$ 可训练参数,其规模被设计成恰好能在 CPU 上摊销边特征查找与逐候选打分 [2](FollowFeed)。作者认为这一容量天花板是阻止该层表达内容与图信号高阶交互的主要瓶颈。
1.4 已有 RAR 方案的不足
GPU 常驻打分催生了 retrieval-as-ranking(RAR)架构(LiNR [1]、GESR [4]、Zhai et al. [15])——单个模型在加速器上同时完成候选检索与精细打分。但作者指出,现有 RAR 多为双塔或 late-interaction,针对纯内容检索优化;它们缺乏在工业粗排延迟下把高基数、成对依赖的边特征融入打分函数的可行机制——根本原因是边特征无法分解为静态的 item 侧表示(它依赖 viewer × author 对)。
因此本文的目标是对 CC 粗排栈做端到端重建,成为一个 GPU-RAR 系统,要做到:(i) 在 GPU 上内联物化 viewer–candidate 边特征;(ii) 通过"非可分解的交互模块"将其与内容 embedding 融合;(iii) 在比旧 CPU 基线高几个数量级的参数规模下维持 120 ms p99 的数万候选打分。
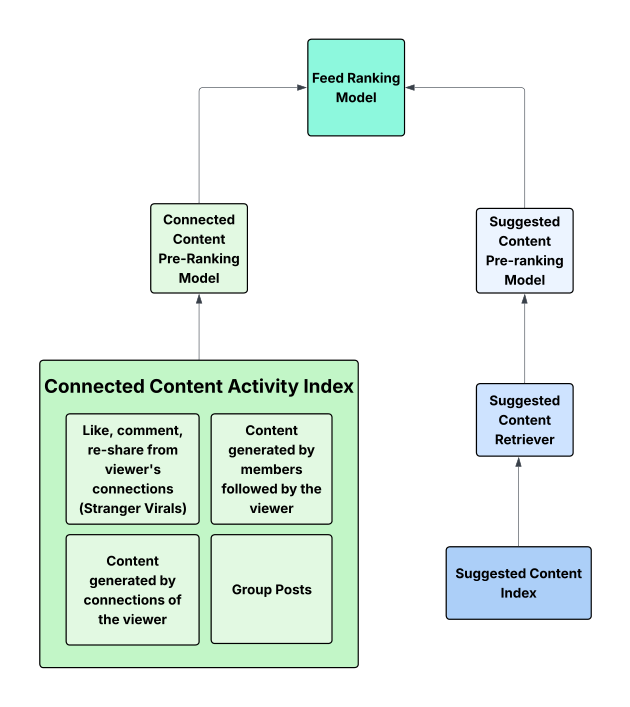
图 1:Feed 检索与排序系统。Connected Content Activity Index 汇集三类内容(一度好友点赞/评论/转发的 stranger viral、关注对象生成的内容、好友生成的内容),经 Connected Content Pre-Ranking Model 粗排;另一路 Suggested Content(非连接内容)由 Suggested Content Retriever 从 Suggested Content Index 检索并粗排;两路汇入 Feed Ranking Model。本文针对的是左侧的 CC 粗排。
二、相关工作定位
论文把相关工作分为四条线:
- GPU 模型化检索:LiNR [1] 把十亿级索引放进可微的 GPU 中,以稠密矩阵运算穷举打分取代 ANN(即 GPU-RAR);SilverTorch [13] 进一步把 ANN 与过滤都实现为 tensor 运算(融合 int8 IVF kernel + GPU bloom index)。二者表明 GPU 上的检索可以比双塔分解更丰富。
- 检索阶段的显式交叉:Tencent [7] 在双塔上加入显式稀疏交叉特征(用户是否与具有某属性的广告交互过,门控实值聚合如 1/7/15/30 天点击数、CTR),用 GPU 压缩倒排表加速;但其交互模块仍是稀疏加权聚合算子,而非对动态 join 的稠密交叉特征运作的通用神经打分器。SparCode [12] 把 query 量化成小词表离线评估所有 (code, item) 对;HSNN [10] 与层次聚类联合学习,使昂贵交互按簇而非按 item 计算——二者都借助中间词表把代价摊销出逐 item 在线计算,但都不在服务时 join 显式交叉特征。
- 粗排阶段的架构创新:GESR [4](Mixture of Attention + 定制 kernel)、TARQ [8](残差量化 + 目标注意力)、HIT [14](保持双塔解耦、预生成整体交互向量)——增益来自更丰富交互的建模架构。
- 扩充服务时交叉特征词表:InteractRank [5](Pinterest,两年日志导出的 query-item 统计)、AIF [6](用户侧与检索并行、item 侧 nearline、残差交互服务时近似)——交叉特征经离线预计算进入粗排,新鲜度取决于更新频率。
本文的定位是:在服务时于 GPU 上实时 join 稠密的 viewer–author 边特征,再交给通用 MLP 打分,而不是离线预计算或通过中间词表摊销。
三、特征体系
模型使用三类特征:
- Document features(文档特征):候选帖子自身属性,如 item popularity、帖子内容 embedding 等——预先索引在 GPU 上;
- Request features(请求特征):请求唯一的特征,如 viewer embedding——请求时传入 GPU;
- Edge features(边特征):需要同时知道 viewer 与候选帖子的 author 才能推导——构造所需的属性在请求时传入 GPU,并在 GPU 上与对应文档 join。
3.1 服务时在线 join 边特征
边特征刻画 viewer 与内容创作者(author)之间的关系,与具体帖子无关。典型例子是 Viewer-Author Action Affinity:编码 viewer 对每个 author 在不同行为类型(like、comment、share、click、long-dwell、follow 等)× 不同时间桶(最近一小时、一天、一周等)上的历史互动,是一个同时刻画强度与新近度的多维向量。这类特征预测力很强,但在请求时 join 到文档上计算代价高。
形式化:服务时收到 $N$ 个候选文档及其 author ID $\mathbf{d}=[d_1,d_2,\dots,d_N]$,以及 $K$ 条 viewer–author 亲密度记录 $(\mathbf{a},\mathbf{F})$,其中 $\mathbf{a}=[a_1,\dots,a_K]$ 为 author ID,$\mathbf{F}\in\mathbb{R}^{K\times D}$ 为对应特征向量。需要输出 $\mathbf{O}\in\mathbb{R}^{N\times D}$:
$$ O_j=\begin{cases}F_i & \text{if } \exists i: a_i=d_j\\ 0 & \text{otherwise}\end{cases} \tag{1} $$
即:若候选 $j$ 的作者出现在 viewer 的亲密度记录中,取对应特征;否则补零。
朴素做法对每个候选扫描全部 $K$ 条记录,复杂度 $O(N\cdot K)$。$N$ 为数万、$K$ 为数千时,量级约 $10^7$,在粗排延迟目标下不可接受。
Algorithm 1:基于二分查找的边特征 join(批量形式,$B$ 为 batch):
输入: 文档 author ID d ∈ Z^{B×N}; 亲密度特征 F ∈ R^{B×K×D}; 亲密度 author ID a ∈ Z^{B×K}
输出: O ∈ R^{B×N×D}
1. a_sorted, idx ← sort(a, dim=1)                 # O(K log K)
2. F_sorted ← gather(F, idx)
3. pos ← searchsorted(a_sorted, d)                # O(N log K)
4. pos_safe ← min(pos, K−1)                       # 防越界
5. valid ← (pos < K) ∧ (a_sorted[pos_safe] = d)   # 校验是否真正命中
6. O ← Zeros(B×N×D)
7. O[valid] ← F_sorted[pos_safe[valid]]
8. return O
思路是:viewer 的亲密度记录只需排序一次,然后对所有文档并行二分查找。复杂度:排序 $O(K\log K)$,二分 $O(N\log K)$,总计 $O((N+K)\log K)$,在 $N\gg K$ 时由 $N\log K$ 主导,比 $O(N\cdot K)$ 朴素扫描少最多约 200 倍运算。摘要称该 sorted-search GPU 原语在 5–10 ms 内完成边特征与 GPU 常驻文档特征的 join。
值得注意的是:这是一个标准的 sort + searchsorted 向量化 join,技术上并不新颖;其价值在于把它放到 GPU 打分路径内,使边特征不必在 CPU 侧逐候选物化后再传输。论文也坦承 Algorithm 1 的伪代码由 Claude 从生产代码转写。
四、模型架构
给定三类特征——请求特征 $x_v$、文档特征 $x_d$、边特征 $x_e$——CC 粗排模型 $f_\theta(x_v,x_d,x_e)$ 是一个多任务前馈网络,约 $O(10^6)$ 参数(正文另处称"few-million"),为三个互动目标(click、totalContributions、long-dwell)输出 logits,最后用可调权重组合成检索分。
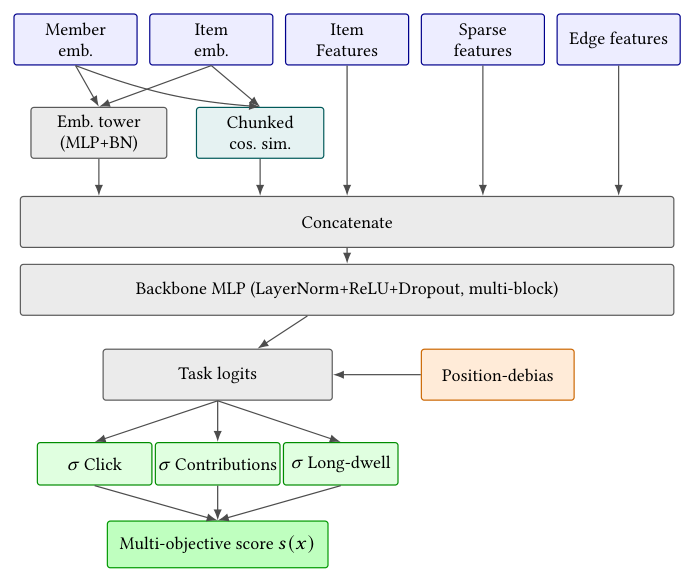
图 2:CC 粗排模型架构。输入为预训练 member 与 item embedding、对数归一化计数特征、multi-hot 稀疏特征,以及按 Algorithm 1 join 成稠密张量的边特征 $x_e$。预训练 embedding 经 ReLU + BN 塔;分块余弦相似度在前向中计算;所有信号拼接后进入 backbone MLP,其 logits 被 Feed 位置去偏 embedding 加性修正;click / total contributions / long-dwell 三个 sigmoid 头以可调权重组合。
4.1 Embedding Tower
预训练的 member embedding(150 维,来自 top-3 medoid)与 item embedding(50 维)[11](LinkedIn Post Embeddings)拼接为 200 维输入,经过 2 层 ReLU + batch-norm 子网络。使用 BN 是为了利用 running statistics 为下游 backbone 提供稳定的输入尺度。
4.2 派生特征(Derived Features)
[11] 中的 member 表示是三个 50 维 medoid embedding 的拼接。作者把每个 medoid 视作与 50 维 item embedding 对齐的一个 chunk,逐 chunk 在 float32 下计算余弦相似度,得到三个标量后再转回 float16(即图中的 "Chunked cos. sim.")。同样,大整数计数特征被转为比率型特征并做 log 变换,全部转为 float16。
4.3 请求特征
viewer 侧特征值随请求传入。除了进入 embedding 塔的 medoid embedding,还使用了序列精排模型最后一层 Transformer 的输出 [3](LinkedIn Feed 工业级序列推荐,arXiv 2602.12354),它编码了成员全部历史互动。——注意这意味着粗排器消费了精排侧大模型的用户表示,这是一个相当强的输入信号。
4.4 Backbone MLP
融合特征 $x\in\mathbb{R}^{d_{\text{in}}}$ 流过若干相同的块:
$$ h_{\ell+1}=\mathrm{Dropout}\big(\mathrm{LayerNorm}(\mathrm{ReLU}(W_\ell h_\ell+b_\ell))\big) \tag{2} $$
最后接一个无激活的线性头,输出三个任务 logits。线性权重用 Kaiming-normal 初始化,偏置为零,每个隐藏块内使用较小的 dropout。
关键观察:论文引言称通过"non-factorizable interaction module"融合边特征与内容 embedding,但实际架构只是拼接 + 普通 MLP——所谓"非可分解"仅意味着它不是双塔点积,而是早期融合。没有专门的特征交叉结构(如 DCN、注意力)。
4.5 位置去偏头(Position-Debias Head)
为防止 backbone 学到排序器的位置偏差,Feed 槽位被当作去偏协变量而非特征:以(截断后的)Feed slot 为键的可学习 embedding 表 $E_{\text{pos}}$ 被加到 backbone logits 上 [16](YouTube 多任务排序的浅塔去偏思路):
$$ \hat{y}=\mathrm{Backbone}(x)+E_{\text{pos}}\big(\min(\text{slot},S_{\max})\big) \tag{3} $$
其中 $S_{\max}$ 为截断阈值,超过它的槽位归入同一桶。训练时对位置项施加中等强度 dropout;推理与验证时 slot 被钳为常数,使偏置项归零,得到纯相关性 logits。
4.6 多目标打分
服务时模型输出三个目标的 logits:click、totalContributions(likes、comments、shares 的并集)、long-dwell。三者的预测概率以可调的逐目标权重线性组合:
$$ s(x)=\sum_{k\in\{\text{click},\,\text{totalContributions},\,\text{long-dwell}\}} w_k\,\sigma\big(\hat{y}_k(x)\big) \tag{4} $$
此外还基于帖子年龄加一个 freshness boost 以鼓励探索。
五、离线评估协议
离线使用 recall@k 衡量粗排模型与精排模型的对齐程度:以每个 session 精排的最终排序为 oracle,用检索器对同一 session 的候选打分,比较 recall@10:
$$ \text{recall@}k=\frac{|R_K\cap M_k|}{K} \tag{5} $$
其中 $R_K$ 是精排的 top-$K$(相关集),$M_k$ 是检索器的 top-$k$。选择 $k=10$ 是因为经验上它与线上指标最一致。
需要指出:这是一个蒸馏式对齐指标——衡量粗排复现精排排序的能力,而非直接衡量用户互动。正文未给出 $K$ 的取值,也未报告任何 recall 的绝对值。
六、在线系统
6.1 端到端架构
系统把三件事解耦:(1) 从大语料中做候选选择;(2) 语料规模的特征存储与检索;(3) 批量推理的 GPU 模型打分。作者称该架构适用于任何检索阶段需要超越 embedding 相似度、纳入丰富特征的推荐系统。
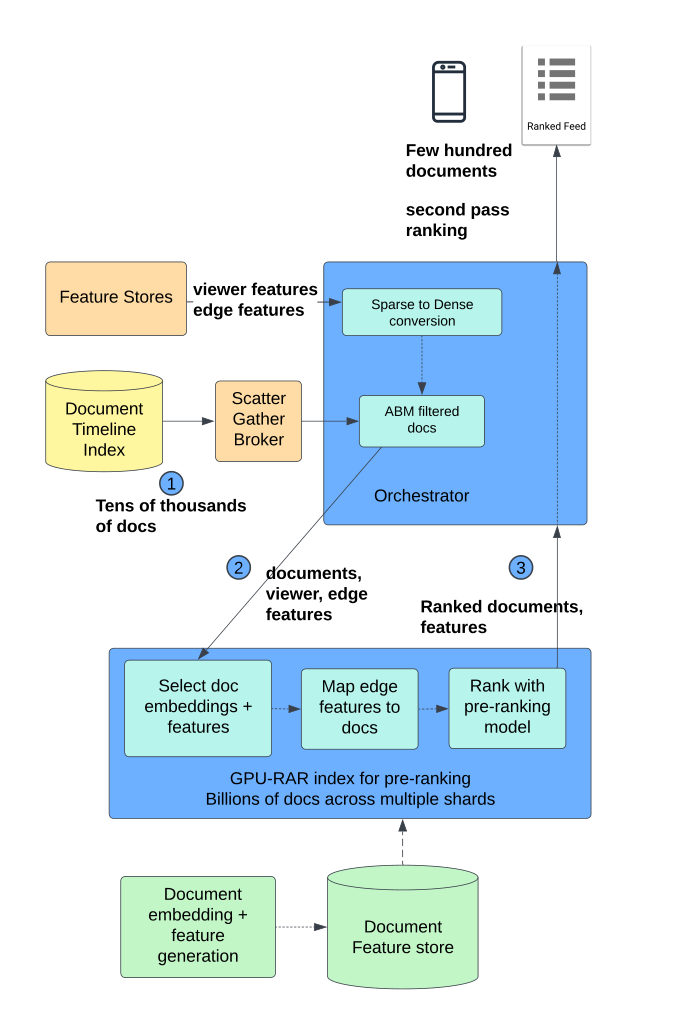
图 3:RAR 系统端到端架构。请求流经三个阶段:(1) 基于图的索引做候选选择,将语料从十亿级过滤到数万;(2) 检索服务生成请求级与边特征并组装打分请求;(3) GPU 推理服务将候选 ID 解析为预索引特征张量,执行批量前向并把 top-K 交给精排。
Stage 1:基于图过滤的候选选择。在 Feed 场景中,用户的相关文档集由社交图定义:只有与用户相连实体创作或互动过的文档才合格。系统使用一个 timeline index,维护"文档作者 → 其近期文档时间线"的映射,支持基于属性的匹配(ABM):给定用户,返回所有作者在其网络内的文档 ID。该过滤把语料缩减 4–5 个数量级(从数十亿到数万)。timeline index 采用 scatter-gather:按作者 ID 分片,编排 broker 把用户网络成员扇出到相关分片、汇总匹配的文档 ID 并去重,从而随语料水平扩展。
Stage 2:检索服务(编排与特征组装)。接收 Stage 1 的候选 ID,按请求计算一次用户级与请求级特征,查询以用户为键的边亲密度张量,组装一个紧凑的打分 payload:候选 ID、用户 query embedding、请求级特征、按实体 ID 索引的边亲密度张量。文档特征与文档 embedding 不在 payload 中传输——它们已预索引在 GPU 推理服务器中,按文档 ID 在服务端解析,使每请求 payload 缩小若干数量级。
Stage 3:GPU 推理服务。接收候选 ID 与用户侧特征,解析为预索引特征张量,执行批量前向。
6.2 摄取管线:保持语料索引新鲜
沿用 LiNR 的"离线批量 + nearline CDC"摄取模式 [1],以流消费文档更新并近实时写入 GPU 索引。本文扩展为两类特征拆分:静态特征(文档创建时一次性计算,如 embedding、内容类型)与动态特征(随互动演化,如 activityPopularity)走两条独立流,索引可分别刷新而无需每次重处理全部特征。静态特征随文档创建的可用性事件到达,缺失字段通过 gRPC 从对应特征服务补齐;动态特征由有状态流作业按固定窗口聚合成员互动并周期性发出。摄取作业并行消费两条流、独立写入索引。
存储效率:扩展 LiNR 的紧凑整数属性编码,把类别特征编码为 32 位整数,支持过滤时的向量化 GPU 比较,相比字符串表示减少一个数量级。每日后台作业逐出超过保留窗口的文档,限定活跃语料规模。
十亿级语料的摄取扩展:维护 GPU 常驻索引的同时处理每秒数万次更新(比平台发帖速率与 LiNR 报告的更新速率高几个数量级),最大陈旧度目标为几分钟。一个 CPU 常驻并行哈希表 $H:\text{DocID}\to\text{Position}$(十亿级条目,数十 GB)把文档 ID 映射到 GPU 张量位置。两种模式:
- Bootstrap(冷启动):重放 CDC 流,按数十万文档一批,执行四步协议:(1) 通过 $H$ 的并行迭代器并行识别新/旧文档 ID;(2) 顺序前缀和为新文档分配存储位置;(3) GPU scatter 把特征写到分配位置;(4) 写成功后才更新哈希表,保证事务一致性。早期实现用张量成员检查(
isin)做批量查找,换成并行哈希迭代器后平均批插入时间提速 52×。 - Steady-state(服务 + 摄取):开始服务后摄取批大小缩小 3 倍,避免与模型执行争抢 GPU 显存带宽;摄取延迟保持在 1 分钟以内。
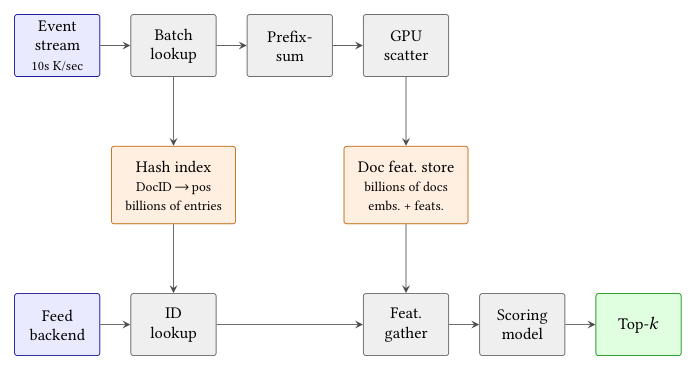
图 4:GPU 推理服务器架构。写路径(上):事件流(每秒数万)经批量查找、前缀和偏移、GPU scatter 更新共享哈希索引与文档特征存储;读路径(下):在 CPU 上解析候选文档 ID,在 GPU 上 gather 特征,执行批量打分前向并选出 top-k。
6.3 超越 embedding 特征的 GPU RAR
GPU RAR 服务器是一个 Rust 实现的推理引擎,在 GPU 显存中完整维护实时文档索引。Feed 检索引擎每请求发送数万(p99)候选 ID,服务器解析为特征张量、组装批输入、执行 TorchScript 模型。十亿级文档被划分为 $S$ 个分片(每片数亿文档)。每个文档存储一组特征张量 $\{f_1,\dots,f_k\}$(embedding、活动信号、内容类型编码等),每文档总占用 $D=\sum_{i=1}^{k}\mathrm{sizeof}(f_i)$ 字节。每个分片须满足:
$$ \frac{N}{S}\times D\le M_{\text{GPU}}-M_{\text{headroom}} \tag{6} $$
其中 $M_{\text{GPU}}$ 为设备总显存,$M_{\text{headroom}}$ 为模型权重、中间激活与 CUDA 分配器开销预留的容量。
6.3.1 生产吞吐下降低 GPU 成本
要在十亿级 GPU 常驻索引上达到每秒数千 QPS、p99 ≤ 120 ms,必须最小化 GPU 空闲、最大化单卡利用率。三项关键优化:把文档 ID 解析移出 GPU;把变长请求批成定长张量;调优内存分配器以防止持续负载下的碎片化。
(1) 文档 ID 解析:从 GPU kernel 改为 CPU 并行查找。每个请求携带数万候选 ID,服务器需通过哈希表 $H$ 解析每个候选 $q_i$ 的索引位置:
$$ \mathrm{pos}(q_i)=\begin{cases}H[q_i] & \text{if } q_i\in H\\ -1 & \text{otherwise}\end{cases} \tag{7} $$
解析在索引级读写锁的读锁下进行;每个在途 batch 持有读锁,摄取按 upsert 批次取写锁。
GPU 常驻哈希表对流式更新索引不实用:每秒数万 upsert 会导致频繁重建,且不规则的指针追逐访问模式与 GPU 合并访存不匹配。因此最初采用标准做法:把 ID→position 映射存为 HBM 中的有序数组,用自定义二分 kernel 解析。单请求在数亿条目索引上约 5 ms;但加入批处理后,kernel 需在同一索引上搜索 $b\times$ 数万个 ID,$O(\log N)$ 单次查找代价叠加顺序 HBM 访问——profiling 显示该 kernel 占模型延迟 >50%,且随 batch 线性增长(batch 1 约 5 ms → batch 8 约 47 ms),封顶了有效 QPS。
解决方案是沿硬件自然边界切分:不规则指针追逐放 CPU,稠密张量运算放 GPU。CPU 常驻并行哈希表以 $O(1)$ 摊销时间解析每个 ID,在约 1 ms 内跨 CPU 线程并发处理整个 $b\times$ 数万的批次,且与 batch 大小无关。GPU 从而专门用于特征 gather 与模型执行,带来 10× 吞吐提升。作者也评估过 GPU 常驻哈希表,但在每秒数万 upsert 下需要持续重建,抵消了吞吐优势;对近静态索引,这一权衡会反转。
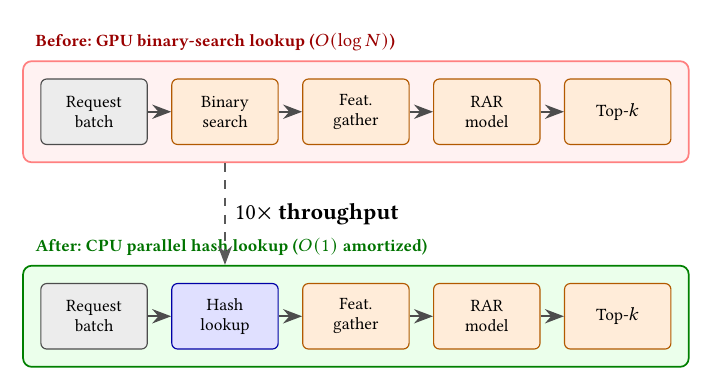
图 5:把文档 ID→位置解析从 GPU 二分查找($O(\log N)$,延迟随 batch 增长)改为 CPU 并行哈希查找($O(1)$ 摊销、基本与 batch 无关),推理路径吞吐提升 10×。橙色为 GPU 操作,蓝色为 CPU 操作。
(2) 变长请求的批处理与 padding。对 $b$ 个请求、各含 $n_i$ 个有效候选,pad 到 $n_{\max}=\max(n_i)$,采用基于 scatter 的方法:(1) 由有效位置掩码计算 scatter 索引 (batch_idx, pos_idx),只算一次、所有特征复用;(2) 把整个 batch 的有效位置展平,从 GPU 索引一次性 gather 特征;(3) scatter 到输出张量 $T[\text{batch\_idx},:,\text{pos\_idx}]$。例如 $b=2$,$R_0$ 有效位置 [10, 42, 87],$R_1$ 为 [5, 63]:scatter 索引 $R_0\to(0,0),(0,1),(0,2)$,$R_1\to(1,0),(1,1)$;展平位置 [10, 42, 87, 5, 63] 一次 gather;scatter 得 $T[0,:]=[\text{f}[10],\text{f}[42],\text{f}[87]]$、$T[1,:]=[\text{f}[5],\text{f}[63],\text{pad}]$。由于 padding 位置可能产生非平凡的 MLP 分数,需用 $\text{scores}[i,j]=-\infty$ 屏蔽。
(3) 受限 headroom 下的 GPU 显存调优。数亿文档张量占据每分片大部分显存,模型激活的剩余空间非常紧张:
$$ M_{\text{total}}=M_{\text{index}}+M_{\text{model}}+M_{\text{activation}}+M_{\text{allocator}} \tag{8} $$
每个 batch 需打分 $b\times n_{\max}$ 个候选,对于几百万参数的模型,每次前向分配与 $b\times n_{\max}\times d_{\text{hidden}}$ 成正比的中间激活,加上特征 gather、embedding 点积、亲密度查找的临时张量。由于索引占据大部分 HBM,每分片只剩几百 MB 连续空间供前向使用。在变 batch 负载下出现两种失败:(i) 经典碎片化 OOM;(ii) CUBLAS_STATUS_ALLOC_FAILED——cuBLAS 在前向中途无法从碎片化空间申请 workspace。分别处理:把 PyTorch 垃圾回收阈值设为 0.6,在已保留内存占用达 60% 时回收未使用的缓存块,限定各 batch 大小下的碎片;再预分配一个固定的 cuBLAS workspace 池 $10\times4096$ KB(约 40 MB)——4096 KB 是 cuBLAS 仍选择最优 Hopper matmul kernel 的最小单 workspace 大小,深度 10 匹配 p99 下的在途 CUDA stream 并发,消除逐 stream 的 workspace 争用。(由此可推断部署硬件为 Hopper 架构 GPU。)
七、实验结果
7.1 GPU-RAR 基准测试(吞吐)
表 1:GPU 推理服务器在 120 ms p99 SLA 下的吞吐演进(每行在上一行基础上加入一项优化;batch size 指单次 GPU 前向中并发打分的请求数)
| Stage | 配置 | Batch Size | QPS |
|---|---|---|---|
| 0 | Baseline:单请求 MLP 前向 | $b$ | OOM |
| 1 | + 内存调优 + 预物化张量 | $b$ | $x$ |
| 2 | + 多请求批处理 | $\le 16b$ | $1.75x$ |
| 3 | + CPU 并行哈希表查找 | $32b$ | $10x$ |
分析:CPU 哈希查找贡献最大(从 1.75x 到 10x,约 5.7 倍),与 6.3.1 节"二分 kernel 占模型延迟 >50% 且随 batch 线性增长"的 profiling 一致——移走它之后 batch 可以从 $\le16b$ 提到 $32b$。但表中 $b$ 与 $x$ 均为脱敏占位符,没有绝对 QPS、GPU 型号数量或每 QPS 成本,无法判断与旧 CPU 系统的成本对比。
7.2 线上 A/B 结果
A/B 对照为:"将带有全部上述特征和基础设施优化的训练模型上线,对比旧模型与旧系统"(ramped online against the older model and system)。报告结果(均 p < 0.0001):
| 指标 | 变化 |
|---|---|
| Content Time Spent | +2.5% |
| Session 量 | +0.1% |
| 被跳过的 updates | −0.8% |
| 专业互动(主动 + 被动互动合计) | +2.68% |
摘要称 +2.5% 的内容时长提升"显著高于 LinkedIn Feed 实验中通常观察到的增益"。
关键审视——线上收益不能归因于边特征:
- 对照组是整套旧系统(CPU 上 $O(10^5)$ 参数的浅层 MLP/双塔 + 旧特征 + 旧服务栈),实验组同时改变了:打分硬件(CPU→GPU)、模型容量(约 50×)、特征集(新增/加密边特征、精排 Transformer 用户表示、LLM 内容 embedding、分块余弦等)、位置去偏与多目标组合、索引新鲜度(数万 upsert/s、分钟级陈旧度)以及可打分候选规模。这是一个打包上线,+2.5% 是整体效果。
- 旧系统本身很可能已经有边特征:引言明言旧 CPU 粗排器的规模是"sized to amortize edge-feature lookup and per-candidate scoring within budget on CPU"——即旧系统也在 CPU 上做边特征查找。因此"引入稠密图边特征"并非从零到有,线上增益与"边特征"之间的因果更加模糊。
- 没有同尺寸、无边特征的线上对照;也没有"GPU 上同尺寸旧模型"或"GPU 上大模型但旧特征集"的中间臂。
- 引言中提到"仅用 LLM 内容 embedding、不做图边条件化"的 A/B 出现显著下降,但没有给出任何数值、时长或对照定义,无法作为证据使用。
7.3 特征消融(离线)
表 2:CC 粗排器特征消融(每行关闭一个输入流,架构与训练保持与完整模型一致;Recall@10 为相对完整模型的百分比变化,固定离线评估集)
| 变体 | Recall@10 Δ |
|---|---|
| Full model(本文) | — |
| w/o edge features | −7.86% |
| w/o content features | −3.05% |
| w/o item features | −2.5% |
分析:在同一新架构、同一容量下,去掉边特征的 Recall@10 下降最大(−7.86%),大于去掉 LLM 内容特征(−3.05%)与 item 特征(−2.5%)。这支持"边特征在该场景携带内容 embedding 无法替代的信号"——这一点在社交图驱动的 CC 场景里符合直觉。
但需要注意几点:
- 这就是论文中唯一的"同尺寸、无边特征"对比,而且是离线 recall 对齐指标,不是线上互动;
- 没有任何 baseline 的离线数值——旧 CPU 模型的 Recall@10 未报告,也没有 GESR / HIT / 双塔等外部方法的离线对比,因此"消融降幅是否超过对最强 baseline 的领先幅度"这一检验无法进行:根本不存在一个可比的 baseline 边距;
- 只报告相对变化,没有绝对 recall、没有方差或多次运行;
- 由于 recall@10 衡量的是"复现精排排序",而精排模型本身大量使用 viewer–author 亲密度信号,粗排去掉边特征后对齐度下降在一定程度上是评估协议的自然结果,并不直接等于用户价值的下降;
- 各特征组的具体内容("content features"是否即 LLM post embedding、"item features"包含哪些)只做了粗略说明。
7.4 参数 scaling 消融
表 3:联合参数 scaling 权衡(backbone 以部署锚点 1× 的参数量倍数表示;ΔRecall@10 相对锚点;相对 QPS 为 120 ms p99 下的单副本吞吐,按最小实测变体归一为 1.00×)
| Backbone(相对部署) | ΔRecall@10 | Rel. QPS |
|---|---|---|
| 部署(1×) | — | deployed |
| ∼4× | +0.11% | 0.93× |
| ∼8× | +0.15% | 0.89× |
| ∼15× | +0.16% | 0.78× |
| ∼40× | +0.20% | 0.67× |
| ∼75× | +0.20% | 0.56× |
| ∼400× | N/A | OOM |
实验保持特征集、训练配方与 embedding 塔固定,同时扩宽加深 backbone,跨两个数量级。结论:离线质量在锚点之后迅速饱和——扩大近两个数量级仅 +0.20% Recall@10,高端每翻倍边际收益 <0.01%;形状与表格 / CTR 模型的递减 scaling law 一致。而吞吐几乎线性下降:中段每翻倍损失约 10–15% 单副本 QPS,接近 100× 时 QPS 减半,最大变体因显存压力无法在单卡上加载。因此部署点定在约 $O(10^6)$。
分析——与"50× 扩参"叙事的张力:
- 摘要把"迁移到 GPU 打分使模型参数扩大 50×"作为头条,但表 3 显示在新特征集之上再扩大 75× 只带来 +0.20% recall——说明在这一 MLP 架构与特征集下,容量并非增益的主要来源;
- 反过来,这并不能推出"50× 的旧→新扩参不重要":表 3 的锚点是新模型(约 $O(10^6)$),旧模型(约 $O(10^5)$)落在曲线的左侧、未测区间,那一段的斜率完全未知。线上 +2.5% 中有多少来自 $10^5\to10^6$ 的容量、多少来自特征、多少来自 GPU 上可以打分更多候选 / 更新鲜的索引,论文没有任何分解;
- 表 3 中 "Rel. QPS 按最小实测变体归一为 1.00×" 与表中"部署(1×)"行写作 "deployed" 略有不一致(表中没有值为 1.00× 的行),推测部署点即归一基准。
八、核心贡献总结
- 把成对边特征带进 GPU 粗排:以 sort + searchsorted 的 GPU 原语在服务时把 viewer–author 稠密亲密度特征 join 到数万候选上(5–10 ms),使非可分解的边特征与 GPU 常驻文档特征一起喂给通用 MLP 打分——超出双塔 RAR 的点积约束;
- 完整的 GPU-RAR 工程栈:timeline index + ABM 图过滤、payload 不传文档特征、两类特征双流摄取、CPU 哈希 + GPU scatter 的十亿级索引维护(52× 插入提速)、CPU 侧 ID 解析(10× 吞吐)、scatter 式 padding、GC 阈值与 cuBLAS workspace 池的显存调优;
- 线上 +2.5% 内容时长(整体系统替换的结果),并以离线消融显示边特征在同一新模型下的贡献最大(−7.86% recall);
- 一个诚实的负面 scaling 结果:在该架构下扩大 75× 仅 +0.20% recall,吞吐近线性下降——为"粗排扩参"提供了反例式数据点。
九、讨论与局限性
9.1 值得借鉴的设计
- "不规则访问放 CPU、稠密计算放 GPU"的硬件边界切分:在流式更新的十亿级索引上,GPU 二分查找随 batch 线性恶化,而 CPU 并行哈希几乎与 batch 无关——这是一个具体、可复用的工程经验,也说明了 GPU 哈希表在高 upsert 率下的不适用性(对近静态索引则相反);
- payload 只传 ID 与请求侧特征,文档特征服务端常驻:显著降低网络与序列化开销;
- 边特征作为"请求级小表 + GPU 端 join":viewer 的亲密度记录只有数千条,按请求传一次、在 GPU 上对数万候选做向量化 join,避免在 CPU 侧物化 $N\times D$ 的边特征张量——这是把成对特征带入 GPU 检索的一种简单而有效的方式,可迁移到任何"候选可按某个键(作者、店铺、广告主)与用户建立成对统计"的场景;
- 显存 headroom 调优的具体参数(GC 阈值 0.6、$10\times4096$ KB cuBLAS workspace 与 Hopper kernel 选择的关系)对 GPU 常驻索引服务很实用。
9.2 局限与争议
- 建模贡献薄弱:模型是拼接 + LayerNorm MLP + 位置去偏 + 三头加权,没有专门的特征交叉结构;引言中的"non-factorizable interaction module"实质就是早融合 MLP。Algorithm 1 也是标准的 sort/searchsorted join。论文的创新主要在服务工程,而非建模;
- 线上收益无法归因到"稠密图边特征":A/B 对照是"旧模型 + 旧系统",实验组同时改变了硬件、容量、特征、去偏、索引新鲜度等多个维度;旧 CPU 系统本身就有边特征查找。按照"引入新信号 ≠ 收益来源"的标准,标题所强调的"Dense Graph Edge Features Powering Pre-Ranking"只有离线同尺寸消融(−7.86% recall)支撑,没有任何线上同尺寸无边特征对照;
- 缺少 baseline 离线对比:没有旧模型或任何外部方法(GESR、HIT、双塔、LiNR 式点积)的 recall 数值,只有相对自身的消融。因此无法判断新系统离线领先多少,也无法检验消融降幅相对于领先幅度的大小;
- "50× 扩参"叙事与表 3 冲突:新模型之上扩 75× 只 +0.20%,而旧→新的 $10^5\to10^6$ 区间完全未测,扩参对线上增益的贡献无从量化;
- 大量数字脱敏:QPS 以 $x$ 与 $b$ 表示,GPU 数量、成本、绝对 recall、recall@k 中的 $K$、A/B 时长与流量比例均未披露;
- 评估指标偏向对齐精排:recall@10 以精排排序为 oracle,本质度量蒸馏对齐;由于精排本身也依赖亲密度信号,边特征消融的降幅部分反映评估协议;
- 可扩展性隐患:候选集由 timeline index 的图过滤硬性决定(仅网络内实体相关的文档),粗排只在这数万条中重排;模型本身是 MLP,作者明示扩参在当前架构下已饱和,后续打算尝试序列建模——说明当前方案在"参数 scaling 同步提升表征与序列建模能力"这一维度上尚无路径;
- "工业署名 ≠ 工业证据":虽然有真实线上 A/B 与 p 值,但对标题主张(边特征驱动)的证据仍停留在离线层面。
9.3 与已有工作的差异
- 相比 LiNR(同公司前作):LiNR 以 GPU 穷举点积做模型化检索,本文在同一 GPU-RAR 范式上加入服务时 join 的成对边特征与多特征 MLP 打分,并把摄取速率提升到每秒数万 upsert;
- 相比 Tencent GPU 交叉特征检索 [7]:后者的交互是稀疏加权聚合算子,本文是稠密边特征 + 通用神经打分器;
- 相比 SparCode / HSNN:二者借助中间词表(query code / item cluster)摊销交互,本文不做摊销,而是依靠图过滤把候选压到数万后直接逐候选打分——这一前提只在"候选集可被社交图强约束"的场景成立;
- 相比 InteractRank / AIF:二者交叉特征离线预计算,本文在请求时实时 join。
9.4 工业落地价值
系统已在 LinkedIn Feed 的 CC 粗排全量服务,并被描述为支撑 LinkedIn 多个用例的 GPU RAR 栈。部署规模:十亿级 GPU 常驻文档索引(分片、每片数亿)、每秒数万次摄取更新、分钟级陈旧度(稳态摄取延迟 <1 分钟)、每秒数千 QPS、p99 ≤ 120 ms、边特征 join 5–10 ms。业务收益:内容时长 +2.5%、session +0.1%、跳过 −0.8%、专业互动 +2.68%(p < 0.0001)。对需要在 GPU 上把成对 user–entity 统计特征带进粗排的团队,第 3 节与第 6 节的工程细节具有直接参考价值;但对"边特征到底贡献了多少线上收益"的问题,论文没有给出答案。