Cascading Relevance-driven Recommendation Network for CTR Prediction in Trigger-Introduced Recommendation
Kaixuan Chen, Wenwen Wang, Xing Fang, Yang Huang, Jing Wang —— Taobao & Tmall Group of Alibaba, Hangzhou, China arXiv:2608.22973v1(2026-08-24,cs.IR)· 代码开源:https://github.com/a-little-cabbage/CRRN
研究动机与背景
TIR:一个被 trigger 锚定的推荐场景
电商平台上出现了一个与传统首页推荐、搜索都不同的场景,论文称之为 Trigger-Introduced / Trigger-Induced Recommendation(TIR,触发式推荐)。它的交互链路是:用户在首页信息流里点击了某个商品——这个被点击的商品被定义为 trigger item(触发物品)——点击行为把用户带进一个新的"承接页/下滑页",页面上展示一串与 trigger 相关的商品;用户在承接页里继续下滑浏览,如果对某个商品感兴趣则再点击进入其详情页。
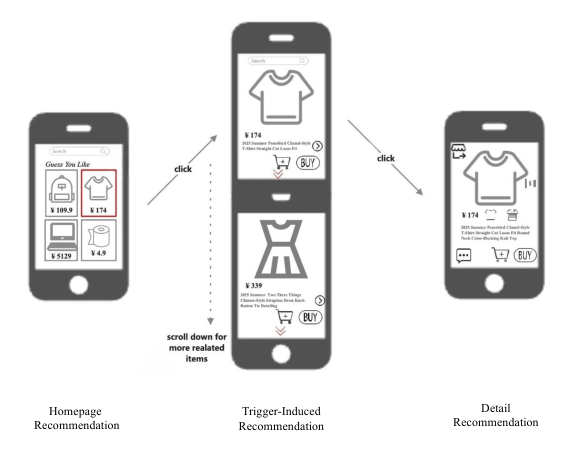
论文对这个场景的定位是:trigger 承载了用户强烈的即时兴趣(instant interest),是一个"独特的实体",必须被特殊对待并与个性化兴趣联合处理。但与搜索场景不同的是,trigger 表达的意图比 query 更模糊、更隐式——用户点了一件短袖 T 恤,究竟是想买同款、想买同品类、还是想搭配裤子裙子,系统只能从 trigger 的属性和用户历史里去猜。
已有工作的缺口:意图建模做得多,相关性建模做得少
论文把已有方法分成两类来批评:
第一类是不显式利用 trigger 的传统工业 CTR 模型,如 DIN [21]、SIM [13],以及一批基于注意力的用户兴趣建模工作 [3][6][8][10][12]。这些方法主要从历史行为里挖掘用户偏好,没有把 trigger 作为一等公民显式建模,在 TIR 场景下不足以提供沉浸式体验。
第二类是 TIR 专用方法,论文逐一点评:
- R3S [19](腾讯):通过特征交互、语义相似度和信息增益捕捉即时兴趣,但忽略了用户历史行为序列这一关键特征;
- DIHN [14]:首个提出 TIR 任务的工作,用 interest highlighting network 预测用户意图,并从历史行为中融合 trigger-relevant 与 target-relevant 特征;
- DIAN [16]:用 intent-aware network 估计用户意图,区分 trigger-aware 与 trigger-free 特征后做加权融合;
- DEI2N [17]:关注下滑过程中 trigger 意图随时间的动态演化,做更细粒度的即时兴趣强度建模。
论文对这三者的共同批评是一句关键判断:
The above methods make great efforts to user's trigger intention while neglecting the enhancement of trigger relevance learning.
也就是说,DIHN / DIAN / DEI2N 这一谱系解决的都是"该给 trigger 多大权重"(意图强度问题),而没有解决"trigger 与 target 之间的相关性本身该如何被显式学习和加强"(相关性问题)。相关性被完全交给 attention 隐式承担,缺乏显式监督。
数据证据:类目对角线上的 CTR 显著更高
论文用一张线上统计图来支撑"相关性是关键信号"这一论断:
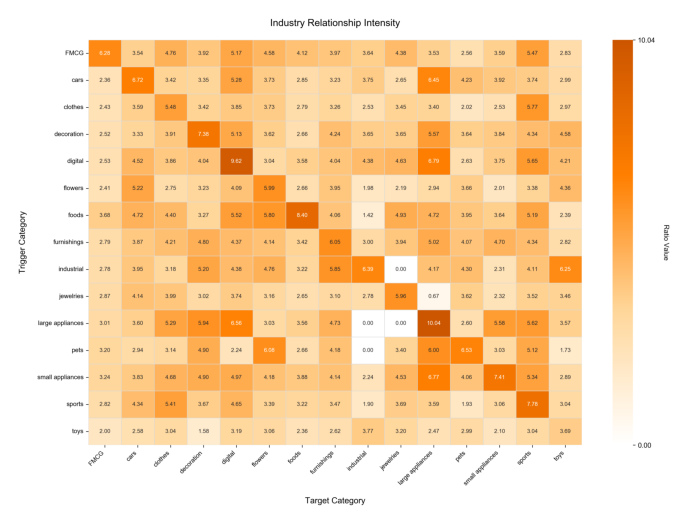
图中横轴是 target item 的类目、纵轴是 trigger item 的类目,共 15 个粗粒度类目(FMCG、cars、clothes、decoration、digital、flowers、foods、furnishings、industrial、jewelries、large appliances、pets、small appliances、sports、toys),色块值是该 (trigger 类目, target 类目) 组合上的平均点击率比值(图内标题为 "Industry Relationship Intensity",色标为 Ratio Value,上限 10.04)。
可以清楚看到对角线(trigger 与 target 同类目)的数值系统性地高于非对角线:large appliances 对角线 10.04、digital 9.82、pets 9.53、foods 8.40、sports 7.78、small appliances 7.41、decoration 7.18、cars 6.72 等,而大多数非对角格子在 2–5 区间。论文由此得出结论:相关性学习是精化用户兴趣、提升推荐准确率的关键信号。
本文的三点贡献
针对上述缺口,论文提出 CRRN(Cascading Relevance-driven Recommendation Network),围绕"强化 trigger 与 target 之间的交互与相关性"设计,贡献总结为:
- 提出显式-隐式混合的 cross-gating 层与类目辅助 pairwise loss,增强 trigger 与 target 之间的交互与相关性;
- 提出级联兴趣融合模块(Cascading Interest Fusion),用预测的 trigger 意图分数与相似度自适应融合即时兴趣与个性化兴趣;
- CRRN 在工业数据集与公开数据集上均达到 SOTA,线上 A/B 实验进一步验证其有效性。
核心方法 / 模型架构
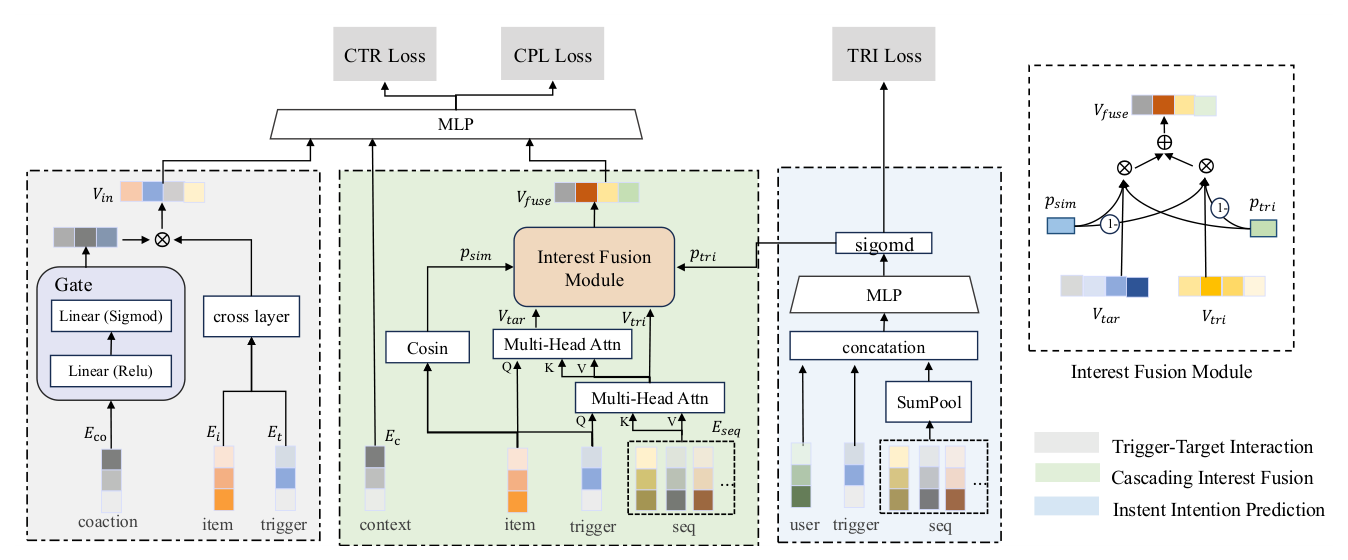
如上图,CRRN 由三个部分组成(图中用三种底色区分):
- 灰色块 · Trigger-Target Interaction:抽取 trigger 与 target 之间的显式与隐式交叉特征,输出 $V_{in}$,受 CTR Loss 与 CPL Loss 监督;
- 绿色块 · Cascading Interest Fusion:用级联注意力块与余弦相似度预测并融合 trigger / target 两路兴趣,输出 $V_{fuse}$;
- 蓝色块 · Instant Intention Prediction:预测用户当前的 trigger 意图概率 $p_{tri}$,受独立的 TRI Loss 监督,并把 $p_{tri}$ 送回绿色块驱动融合。
所有特征最终拼接后送入 MLP 预测 CTR 概率。
特征体系与符号
CRRN 接收 5 类特征:
- User Profile:user id、user age 等用户静态属性 → $E_u$;
- User Behaviors:用户点击/购买过的物品列表,反映历史偏好 → $E_{seq} = \{E_i^1, E_i^2, \ldots, E_i^L\}$,$L$ 为行为序列长度;
- Trigger features:trigger id、trigger category、trigger brand 等属性 → $E_t$;
- Target features:与 trigger 同构的目标物品属性 → $E_i$;
- Context features:时间戳、浏览位置等 → $E_c$。
每个特征先编码为 one-hot,再经 embedding 层转成低维稠密向量(沿用 DIN [21] 的做法),然后拼接成完整特征。
A. Trigger-Target Interaction(触发-目标交互层)
动机:用户点击 trigger 并进入下滑页这一事实本身,就说明用户对 trigger 相关物品有强意图。因此探索 trigger 与 target 的复杂关系,是判断当前候选是否契合用户即时兴趣的关键。论文指出已有方法多用简单拼接或直接相乘来组合 trigger 与 target 特征,无法捕获更高阶、更复杂的交叉关系。
做法分两步:
- 先用 element-wise 乘法抽取 trigger 与 target 的交互特征,强化二者的共性;
- 再基于 coaction 特征 $E_{co}$(例如二者是否属于同一类目、同一品牌、同一价格档位),用一个双层门控网络去增强并自适应调节这个交互特征,得到精化后的交互表征 $V_{in}$:
$$V_{in} = \mathrm{gate}(E_{co}) \odot E_t \odot E_i \tag{1}$$
$$\mathrm{gate}(x) = \mathrm{Sigmoid}(W_1 \cdot \mathrm{ReLU}(W_0 x + b_0) + b_1) \tag{2}$$
其中 $\odot$ 表示 element-wise 乘法,$W_0, W_1$ 是待学习的投影矩阵。
物理含义:$E_t \odot E_i$ 是"隐式"的高维共性信号;$\mathrm{gate}(E_{co})$ 是由人可解释的显式共现属性(同类目/同品牌/同价格档)驱动的逐维缩放因子。二者相乘,等价于让显式的相关性判定去门控隐式的向量交互——这就是论文说的"explicit-implicit hybrid manner"。从 Fig 2 可以看到,$E_i$ 与 $E_t$ 除了走 gate 分支外还并行经过一个 cross layer,其输出与门控后的交互特征相乘再拼进 $V_{in}$。
B. Cascading Interest Fusion(级联兴趣融合)
动机:在 TIR 场景里,既要从历史行为序列里抽取用户兴趣,又要同时兼顾 trigger 与 target。论文批评已有方法"简单拼接 trigger 注意力特征与 target 注意力特征而不考虑二者关系",这削弱了 trigger 的作用。CRRN 改用级联注意力块,通过预测的 trigger 意图分数与相似度自适应融合即时兴趣与个性化兴趣,从而隐式地强化 trigger 相关性。
B.1 Instant Intention Prediction(即时意图预测)
如 Fig 2 蓝色块:用户特征 $E_u$、trigger 特征 $E_t$、以及 sum-pooling 后的序列特征 $f_{sp}(E_{seq})$ 拼接后送入 MLP,经 sigmoid 得到当前的 trigger 意图分数,表示用户对 trigger 相关物品的兴趣强度:
$$\hat{p}_{tri} = \mathrm{Sigmoid}(\mathrm{MLP}([E_u \oplus E_t \oplus f_{sp}(E_{seq})])) \tag{3}$$
$$\mathcal{L}_{tri} = -\frac{1}{N}\sum_{(x,y)\in S}^{N}\left(y\log(p(x)) + (1-y)\log(1-p(x))\right) \tag{4}$$
其中 $\oplus$ 表示拼接,$f_{sp}(\cdot)$ 表示 sum-pooling,$S$ 是大小为 $N$ 的训练集,$y$ 是 trigger 意图标签。
标签是怎么造的(这是本模块最关键的工程细节):意图标签是页面级(page-level)的点击指示器——如果该页面上被点击的物品与 trigger 属于同一类目,则意图标签置为 true,表示用户当前对 trigger 有强意图。论文明确说明:意图标签只在训练时作为监督信号使用,推理时不使用(推理时使用的是模型预测出的 $\hat{p}_{tri}$)。
B.2 Cascading Attention(级联注意力)
级联融合模块先对 target item 与历史行为做多头注意力(Vaswani et al. [15]),抽取用户多峰的历史行为兴趣;随后以同样方式再把 trigger 信息接进来,从而强化 trigger 的重要性,更完整地考虑 user–trigger–target 三元关系。以 target attention 为例:
$$V_{tar} = W^o[\mathrm{head}_1^{tar} \oplus \mathrm{head}_2^{tar} \oplus \ldots] \tag{5}$$
$$\mathrm{head}_i^{tar} = f_{attn}(W_q E_t,\, W_k E_{seq},\, W_v E_{seq}) \tag{6}$$
$$f_{attn}(Q, K, V) = \mathrm{softmax}\left(\frac{QK}{\sqrt{d}}V\right) \tag{7}$$
其中 $W_q, W_k, W_v$ 是待学习的投影矩阵。Trigger attention 用同样方式处理,但把 query 设为 trigger 特征、key 设为 target attention 的输出,得到 trigger 注意力输出 $V_{tri}$。
对照 Fig 2 绿色块可以看清级联结构:下层 Multi-Head Attn 的 Q 来自 item(target)、K/V 来自 seq,输出 $V_{tar}$;上层 Multi-Head Attn 的 Q 来自 trigger、K/V 来自下层的输出,得到 $V_{tri}$。也就是说 $V_{tri}$ 是"在已被 target 激活过的兴趣表征之上,再由 trigger 做一次激活",而不是与 $V_{tar}$ 并行独立计算——这正是"cascading"的含义,也是与 DIHN/DIAN 那种"并行两塔再加权拼接"的关键区别。
注:式 (6) 印刷为 $W_q E_t$,但按正文"personalized learning on the target item"的表述与 Fig 2 的连线(Q 来自 item),target attention 的 query 应为 $E_i$,此处应为笔误;式 (7) 也漏写了 $K$ 的转置且 $V$ 被写进了 softmax 内部。
B.3 Interest Fusion(兴趣融合)
最后,基于前述 trigger 意图分数,把即时兴趣与个性化兴趣自适应融合成增强后的兴趣特征 $V_{fuse}$。论文额外引入 trigger 与 target 的相似度来修正两路权重,理由是:trigger 与 target 越相似,就越应该加大 trigger 相关兴趣的重要性。
$$V_{fuse} = \hat{p}_{tri}\cdot s(E_t, E_i)\cdot V_{tri} + (1-\hat{p}_{tri})\cdot(1-s(E_t, E_i))\cdot V_{tar} \tag{8}$$
$$s(E_t, E_i) = \frac{E_t^{\top}E_i}{\lVert E_t\rVert \lVert E_i\rVert} \tag{9}$$
其中 $s(\cdot,\cdot)$ 是余弦相似度。Fig 2 最右侧的 Interest Fusion Module 子图把这个交叉结构画得很清楚:$p_{sim}$ 与 $p_{tri}$ 两个标量各自分出"原值"与"$1-$"两条线,交叉地乘到 $V_{tri}$ 与 $V_{tar}$ 上再相加。
设计含义:融合权重是意图强度与语义相似度的乘积,即只有当"用户确实有 trigger 意图"且"候选与 trigger 确实相似"两个条件同时成立时,trigger 侧兴趣才会被放大;反之两个条件都不成立时才完全走个性化兴趣。这是一个 AND 形式的软门控,比单一意图分数更保守。
C. Category-assisted Pairwise Loss(类目辅助 pairwise 损失)
动机:论文认为"用注意力去建模 trigger 相关性过于隐式",因此把相关性直接写进损失函数,去引导候选物品点击概率的估计。
传统 pairwise loss 建立的偏序关系只有一层:点击 > 曝光。CRRN 引入类目相关性,把偏序细化为四层:
$$\text{点击且相关} \;>\; \text{点击但不相关} \;>\; \text{曝光且相关} \;>\; \text{曝光但不相关}$$
这里"相关(relevance)"的定义就是 target 与 trigger 同类目。
$$\mathcal{L}_{cpl} = -\frac{1}{N^2}\sum_{i=1}^{N}\sum_{j=1}^{N}\left(y_p\log(\hat{y}_{ctr}^{i} - \hat{y}_{ctr}^{j}) + (1-y_p)\log\left(1 - (\hat{y}_{ctr}^{i} - \hat{y}_{ctr}^{j})\right)\right) \tag{10}$$
其中 $y_p \in \{0,1\}$ 是物品 $i$ 与物品 $j$ 的序关系标签。
这一步的价值判断:把"同类目"这个可从类目体系直接读出的、零标注成本的先验,转成 $N^2$ 对样本上的显式序关系约束——相当于用 Fig 3 那张热力图的统计规律直接给排序打了一层结构化的先验。相比让 attention 自己去发现"同类目更容易被点",这是监督信号层面的干预而非结构层面的干预,这也是 CRRN 与 DIHN/DIAN/DEI2N 谱系最本质的差异。
注:式 (10) 按原文照录。$\log(\hat{y}^i - \hat{y}^j)$ 在两个 CTR 预估值之差为负时无定义,标准 RankNet 形式应为 $\log\sigma(\hat{y}^i - \hat{y}^j)$,这里几乎可以确定是漏写了 sigmoid。
D. 总损失
所有特征拼接后送入 MLP 做 CTR 预测,其损失 $\mathcal{L}_{ctr}$ 是与式 (4) 同形的负对数似然。CRRN 的总损失为:
$$\mathcal{L} = \mathcal{L}_{ctr} + \lambda\mathcal{L}_{tri} + \theta\mathcal{L}_{cpl} \tag{11}$$
其中 $\lambda, \theta$ 是平衡超参。论文对三项损失的分工描述得很明确:
- $\mathcal{L}_{ctr}$:保证模型基于历史行为准确学到用户兴趣与偏好,保证整体学习方向正确;
- $\mathcal{L}_{tri}$:学习用户对 trigger 的兴趣强度,从而精确引导并平衡即时兴趣与个性化兴趣;
- $\mathcal{L}_{cpl}$:通过比较物品对的类目显式强化 trigger 相关性。
实验设置
数据集
工业数据集:来自 Tmall app(论文称其为最大的购物平台之一,聚焦品牌商品),采集用户历史行为与日志信息,样本时间窗为 2025 年 8 月 20 日至 10 月 20 日,约 5 亿样本,每条样本包含 user / sequence / trigger / target / context 信息。验证集与测试集分别取自 10 月 20 日与 10 月 21 日,各约 700 万样本。标签定义:首页推荐中被点击的物品即 trigger item,它触发跳转到下滑页(即 TIR 页);用户在下滑页点击了物品则标签为 1,否则为 0。
公开数据集:来自阿里巴巴 Alimama 广告平台(Tianchi dataId=56),涉及 100 万用户、80 万广告物品,处理后共 2600 万样本。论文诚实地说明:该数据集并非严格的 TIR 数据集,因为它缺少 trigger item 信息。因此沿用 DIHN [14] 的方案,把样本发生前 4 小时内最近一次点击的物品定义为 trigger item,无法关联到 trigger 的样本直接丢弃。
| Dataset | Users | Items | Samples |
|---|---|---|---|
| Industrial Dataset | 7,692,277 | 22,512,661 | 449,786,531 |
| Public Dataset | 1,366,056 | 846,812 | 26,557,962 |
(Table I。注意工业数据集的实际用户数 769 万、物品数 2251 万,样本 4.5 亿。)
实现细节
- 优化器:Adagrad [5],学习率初始 0.001,衰减率 0.95;
- Batch size 1024,训练 4 个 epoch;
- 损失权重:$\lambda = 0.2$,$\theta = 0.5$(实验设定,用于平衡损失);
- 行为序列长度固定为 100(覆盖大多数序列长度),不足补 mask、超出截断;
- 评估指标:AUC 与 RelaImpr(CTR 预估任务的常用指标)。
RelaImpr 的定义是相对于 base 模型的相对提升:$\mathrm{RelaImpr} = \left(\frac{\mathrm{AUC}_{model} - 0.5}{\mathrm{AUC}_{base} - 0.5} - 1\right) \times 100\%$,本文所有表的 base 均为 DIN+TRA。
对比方法
- Wide&Deep+TIR [2]:联合训练 wide 线性模型与 deep 网络,兼顾记忆与泛化;本文为其补充 trigger 相关特征作为输入以捕获即时兴趣;
- DIN+TAR [21]:用注意力机制从历史行为中自适应学习用户兴趣表征,同时使用 trigger 与 target;这是线上原有模型;
- DIHN [14]:首个提出 TIR 任务的工作,用深度网络学习用户意图;
- DIAN [16]:intention-aware network,通过动态平衡 trigger-free 与 trigger-aware 两路结果来识别用户意图;
- DEI2N [17]:引入 instant interest layer,学习用户点击 trigger 后即时兴趣强度的动态变化,做更细粒度的兴趣建模。
论文说明为公平比较,给 Wide&Deep 与 DIN 都装上了基于 trigger 相关特征的即时兴趣建模。
主要实验结果
Table II:主对比(AUC / RelaImpr)
| Model | Industrial AUC | Industrial RelaImpr | Public AUC | Public RelaImpr |
|---|---|---|---|---|
| Wide&Deep+TR | 0.6634 | −0.85% | 0.6310 | −3.03% |
| DIN+TRA | 0.6648 | 0.00% | 0.6351 | 0.00% |
| DIHN | 0.6664 | +0.97% | 0.6388 | +2.74% |
| DIAN | 0.6693 | +2.73% | 0.6408 | +4.22% |
| DEI2N | 0.6723 | +4.55% | 0.6428 | +5.70% |
| CRRN | 0.6752 | +6.31% | 0.6448 | +7.18% |
结论分析:
- trigger 系方法整体优于传统方法:DIHN / DIAN / DEI2N / CRRN 全部显著超过 Wide&Deep 与 DIN,说明 trigger 信息与意图估计在 TIR 场景确实关键。值得注意的是 Wide&Deep+TR 的 RelaImpr 为负(工业 −0.85%、公开 −3.03%),即便补了 trigger 特征也打不过 DIN——说明光把 trigger 当特征塞进去不够,必须有结构化的兴趣建模。
- DEI2N 是除本文外最好的方法,论文由此认为"抽取交互特征是必要的"。
- CRRN 在两个数据集上都最优。但要看清楚绝对增量很小:工业数据集上比 DEI2N 高 0.0029 AUC(0.29 个百分点),公开数据集上高 0.0020 AUC(0.20 个百分点)。论文没有报告方差或显著性检验,这个量级的差距在单次实验下证据强度有限。
- 论文给出的机制解释是:CRRN 综合利用了 trigger 与 target 的复杂关系,并通过级联注意力块与类目辅助的序关系学习增强了相关性表征,从而更准确地平衡即时兴趣与个性化兴趣。
Table III:模块消融(工业数据集)
Baseline 为 DIN+TRA(线上原有模型)。
| Model | TTI | CIF | CPL | AUC | RelaImpr |
|---|---|---|---|---|---|
| Baseline | ✗ | ✗ | ✗ | 0.6648 | 0.00% |
| B+TTI | ✓ | ✗ | ✗ | 0.6702 | 3.27% |
| B+CIF | ✗ | ✓ | ✗ | 0.6726 | 4.73% |
| B+CPL | ✗ | ✗ | ✓ | 0.6691 | 2.61% |
| CRRN | ✓ | ✓ | ✓ | 0.6752 | +6.31% |
(原表表头误写为 "IEF",正文一致称 CIF。)
逐项分析(论文用绝对 AUC 增益百分点表述):
- TTI(Trigger-Target Interaction)+0.54 点:通过学习 trigger 与 target 之间的显式与隐式交叉关系,为最终任务提供更全面的特征;
- CIF(Cascading Interest Fusion)+0.78 点:贡献最大的单模块,帮助模型判定并平衡即时兴趣与个性化兴趣;
- CPL(Category-assisted Pairwise Loss)+0.43 点:弥补对 trigger 相关性挖掘的不足,细化每对物品之间的类目关系学习。
一个论文没有讨论但值得注意的现象:三个模块单独增益之和为 0.54 + 0.78 + 0.43 = 1.75 点,而完整 CRRN 相对 baseline 的总增益只有 0.6752 − 0.6648 = 1.04 点。也就是说三个模块存在明显的功能重叠(sub-additive)——这完全说得通:TTI 的 coaction 门控、CIF 的余弦相似度加权、CPL 的同类目偏序,本质上都在向模型注入同一个"类目相关性"信号,只是分别作用在特征层、融合层和损失层。论文把它们当作互补组件叙述,但数据显示三者更接近同一信号的三种冗余注入方式。
Table IV:CPL 相关性定义的消融
论文在 CPL 模块中把"相关"的判定依据换成品牌、店铺、价格档位分别做实验:
| Model | AUC | RelaImpr |
|---|---|---|
| Baseline | 0.6648 | 0.00% |
| CRRN-price | 0.6735 | 5.28% |
| CRRN-brand | 0.6721 | 4.43% |
| CRRN-shop | 0.6718 | 4.25% |
| CRRN-category | 0.6752 | +6.31% |
结论:类目最好,其余三者提升相对有限。论文给出两条解释:
- 与特征重要性分析一致:category coaction 特征的重要性得分最高——category 0.0071 > price-level 0.0026 > brand 0.0011 > shop 0.00079;
- 机制上,同品牌或同店铺的商品往往更加多样化,不足以满足即时兴趣建模的需求;而类目"保持了一种平衡的相关性而不至于过度聚焦",既符合 TIR 场景的相似度要求,又能直观反映用户意图。
这个消融是全文最有信息量的一个:它说明相关性的粒度选择本身是一个可调的设计变量,太细(店铺/品牌)会因为多样性不足而失效,太粗则无区分度,类目恰好落在合适的粒度上。
Table V:相似度度量方式的消融
论文比较了在式 (8) 中用不同方式度量 trigger 与 target 相似度(作为 trigger 意图强度的修正项):
| Model | AUC | RelaImpr |
|---|---|---|
| Baseline | 0.6648 | 0.00% |
| CRRN-MLP | 0.6739 | 5.52% |
| CRRN-bilinear | 0.6747 | 6.01% |
| CRRN-CL(对比学习预训练) | 0.6743 | 5.76% |
| CRRN-cosine | 0.6752 | +6.31% |
结论:余弦相似度最好。论文的解释是余弦相似度能最大程度保留物品的原始特性,而这对用户决策相对重要;反观 MLP / bilinear / 对比学习这些带可学习参数的方式,可能捕获到高维特征,从而偏离了基础的相关性语义。
这是一个反直觉但很实用的结论:在这个位置上"参数更多≠更好",因为该标量的作用是充当一个语义先验的调节器,一旦可学习就会被 CTR 主目标带跑、退化成又一个自由参数。不过四种方案的差距只有 0.13 个 AUC 点,结论的鲁棒性也需保留。
Table VI:训练与推理效率(epoch = 1)
| Method | Training (min) | Prediction (min) | Online |
|---|---|---|---|
| Wide&Deep+TR | 102 | 8 | – |
| DIN+TRA | 127 | 10 | 42ms |
| DIHN | 134 | 11 | – |
| DIAN | 137 | 11 | – |
| DEI2N | 135 | 11 | – |
| CRRN | 134 | 11 | 45ms |
结论:Wide&Deep+TR 因为不做注意力序列建模而最快;DIHN / DIAN / DEI2N / CRRN 因为都加了 trigger 相关兴趣模块,比 DIN+TRA 慢约 7–10 分钟,CRRN 与同类方法基本持平。也就是说,用于学习 trigger 交互特征的额外 MLP 和意图建模没有引入显著的时间开销。
线上侧:CRRN 部署在 NVIDIA L20 GPU 上,相比 baseline 只增加 2ms(42ms → 45ms),完全满足线上 150ms 的服务要求。
线上 A/B 与部署证据
Table VII:线上 A/B 结果
论文在 Tmall 平台上于 4 月 10 日至 17 日进行了线上 A/B 测试,对照组为 DIN with trigger attention(线上原有模型)。PV 与 IPV 分别表示用户在 TIR 场景下浏览与点击的平均物品数(Page View / Item Page View)。
| Method | IPV | PV | CTR |
|---|---|---|---|
| DIN+TAR | 0.87 | 19.70 | 3.11% |
| CRRN | 0.92 | 20.34 | 3.23% |
| Lift rate | +5.75% | +3.25% | +3.87% |
论文明确写道:"And now CRRN is serving online."(CRRN 已全量服务线上)。
Table VIII:线上细粒度类目相关性统计
为了回答"CRRN 到底好在哪",论文对线上推荐结果做了更细粒度的类目划分统计,把候选分为 SC(Same Category,同类目)/ RC(Related Category,相关类目)/ DC(Different Category,不同类目):
| Method | SC | RC | DC |
|---|---|---|---|
| DIN+TAR | 40.51% | 7.16% | 52.33% |
| CRRN | 67.45% | 21.31% | 11.24% |
| diff | +26.94% | +14.15% | −41.09% |
分析:
- 相对 base 模型,SC 与 RC 的推荐占比大幅上升,DC 占比从 52.33% 降到 11.24%,说明 CRRN 确实通过隐式特征交互 + 显式相关性增强,把推荐结果拉向了 trigger 相关的区域;
- 论文特别强调 DC 仍保持 11.23% 的可观份额不是缺陷而是设计目标:相关性与个性化的平衡对用户体验至关重要——相关性太弱会让推荐过于发散、无法满足即时兴趣;相关性太强则会让整屏都是相似商品,造成用户疲劳。CRRN 通过有监督的意图建模在二者之间取得平衡。
这张表是全文最有说服力的证据之一:它把"AUC +0.29 点"这个抽象数字翻译成了推荐结果分布层面 41 个百分点的结构性位移,直接对应到用户可感知的沉浸式体验。
泛化性讨论
论文认为 CRRN 适用于 TIR 场景及其"相关/相似推荐"变体,这类场景在电商、新闻、视频等多个领域被广泛采用,例如淘宝、Amazon 的相关推荐,以及新闻、视频 app 里的相关推荐位。
Case Study
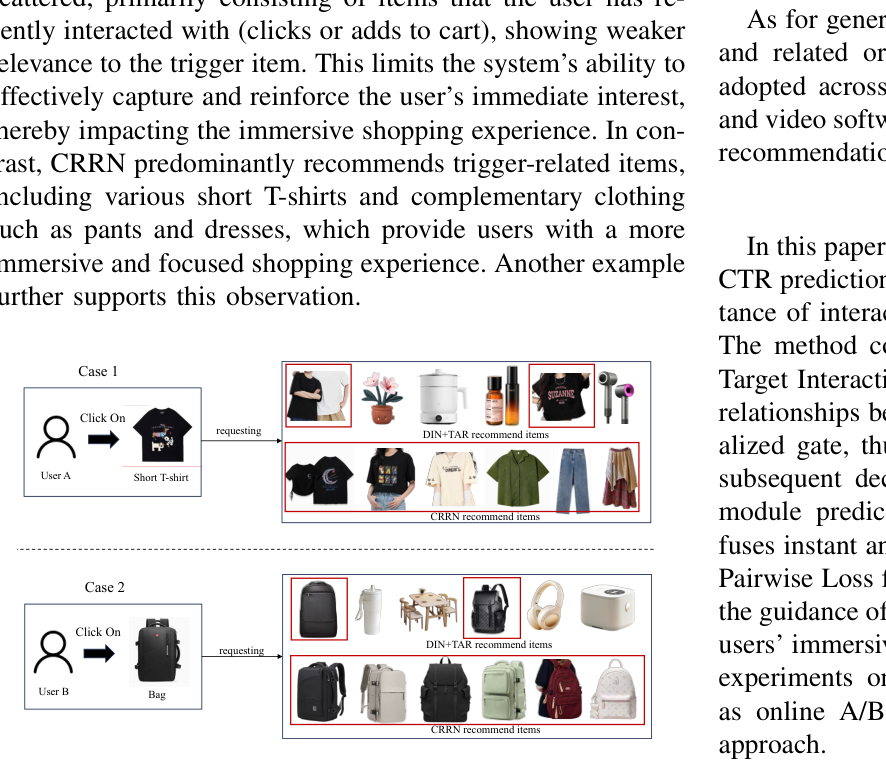
论文用两个真实推荐样例展示相关性的增强效果:
Case 1:用户 A 点击了一件短袖 T 恤作为 trigger 进入 TIR 场景。使用 DIN+TAR 时,推荐的物品类目相对分散,主要由用户近期交互过(点击或加购)的物品构成,与 trigger 的相关性较弱——这限制了系统捕获与强化用户即时兴趣的能力,损害沉浸式购物体验。使用 CRRN 时,推荐结果以 trigger 相关物品为主,包括各类短袖 T 恤以及裤子、连衣裙等互补服饰,提供了更沉浸、更聚焦的购物体验。
Case 2:用户 B 点击了一个包作为 trigger,观察到同样的现象。
值得注意的是 Case 1 中 CRRN 推荐的"裤子、连衣裙"属于互补品而非同款,这说明模型学到的相关性并不是简单的"同类目复读"——尽管 CPL 的监督信号只用了同类目二值判定,最终行为却包含了搭配语义,这一点论文没有展开分析。
核心贡献总结
- 问题定位:明确区分了 TIR 研究中的两个不同问题——"trigger 意图强度"(DIHN/DIAN/DEI2N 谱系已充分研究)与"trigger 相关性"(此前被忽略),并用线上类目对 CTR 热力图(Fig 3)为后者提供了数据证据。
- 显式-隐式混合门控(TTI):用可解释的 coaction 特征(同类目/同品牌/同价格档)门控 element-wise 的高维交互,把显式相关性判定与隐式向量交互结合。
- 级联而非并行的兴趣融合(CIF):trigger attention 建立在 target attention 输出之上而非与之并行,并用"意图分数 × 余弦相似度"这一 AND 型软门控做融合,避免简单拼接稀释 trigger 作用。
- 类目辅助 pairwise loss(CPL):把传统"点击 > 曝光"的二层偏序细化为"点击且相关 > 点击不相关 > 曝光相关 > 曝光不相关"的四层偏序,用零标注成本的类目体系把相关性从隐式变为损失函数层面的显式约束。
- 完整的工业证据链:4.5 亿样本的 Tmall 数据集、线上 A/B(+3.87% CTR、+5.75% IPV)、部署延迟(L20 GPU 上 +2ms)、线上推荐分布位移统计(DC 占比 −41 点),并开源代码。
与已归档相关工作的对比
SAM SAM: Learning to Forget — Satiation-Aware Long-Sequence Transducers (Alibaba Group, 2026-07-14)
关系:独立并发(本文未引用 SAM,两者殊途同归;且两篇作者存在重叠——Xing Fang / Yang Huang / Jing Wang 同时出现在两篇的作者列表中,属同团队的两条平行工作线)· 已加载对方精读
- 共同关注的问题:两篇都在攻击同一个结构性缺口——工业电商 CTR 模型中"候选物品与某个锚点之间的类目相关性该被赋予多大权重"这件事,被完全交给自注意力隐式学习,缺乏显式的、可监督的调节机制。CRRN 的锚点是 trigger item(用户刚点进来的那个商品),SAM 的锚点是最近一次 purchase item;CRRN 抱怨"相关性不够、推荐发散、失去沉浸感",SAM 抱怨"相关性过头、购后仍反复推同品类、浪费优质坑位"。二者是同一根轴上的两个失效方向,共同的 root cause 是注意力机制只会累积正信号,无法自主决定何时该放大、何时该收敛对锚点类目的偏好。
- 相近的技术骨架:抽象后两者的流程图几乎重合——(a) 从用户特征/序列中预测一个标量状态量(CRRN:trigger 意图概率 $\hat{p}_{tri}$;SAM:预测的补货周期 $c$ 与意图归属权重 $a_j$);(b) 这个标量由一个独立的辅助监督任务训练,而标签都是从行为日志里零成本挖出来的弱标签(CRRN:页面级"被点物品是否与 trigger 同类目"的意图标签 + TRI Loss;SAM:Time-to-Next-Purchase 自监督任务);(c) 标量随后驱动一个软门控去重新加权兴趣表征(CRRN:$\hat{p}_{tri}\cdot s(\cdot)$ 与 $(1-\hat{p}_{tri})(1-s(\cdot))$ 交叉加权两路注意力输出;SAM:ASGU 生成 satiation mask $m_{ij}$ 注入注意力 logit);(d) 两者都把 item category 作为相关性判定的实际粒度(CRRN 的 coaction 与 CPL 都以类目为准;SAM 的 intent localization 用品类 embedding 做 probe query)。
- 本文的差异与推进:CRRN 把干预点放在损失函数上——CPL 用四层偏序把相关性写成排序约束,这是 SAM 没有做的;SAM 的干预点全部在注意力 logit 与门控结构上,损失侧只加了一个回归型 TTNP 辅助任务。另一个差异是时间维度:SAM 的门控是显式时间函数(satiation 随 $\Delta t / c$ 衰减、还带 lead-in 提前召回),建模的是意图的生命周期;CRRN 的门控是无时间维的静态标量,只回答"此刻意图有多强",不回答"这个意图还能持续多久"——考虑到 TIR 是单次会话内的下滑场景,这个简化是合理的,但也意味着 CRRN 无法处理"用户下滑十几屏后 trigger 意图逐渐衰减"这一现象(而这恰恰是 DEI2N 关注的问题)。
- 可比的方法/实验差异:两篇都在阿里系电商数据上验证并均已上线,但指标口径不同——SAM 以 GAUC 与 Post-Purchase Repeat Rate(降幅 >60%)为核心指标,CRRN 以 AUC/RelaImpr 加线上 SC/RC/DC 分布位移为核心指标。有意思的是两者的"效果证明方式"高度相似:都不满足于 AUC 微小提升,而是补一个推荐结果分布层面的统计来说明模型真正改变了什么(SAM 的重复率、CRRN 的同类目占比)。两篇都没有对方的实验对照,若把 SAM 的 ASGU 与 CRRN 的 CPL 组合(同时具备"何时放大"与"何时抑制"的类目相关性调节),是一个自然但未被验证的方向。
讨论与局限性
值得借鉴的设计
- 把统计先验直接转成损失约束。CPL 的思路可以脱离 TIR 场景复用:任何时候如果你能从日志里画出一张"某个属性对齐 → 转化率显著更高"的热力图,就可以把这个属性对齐关系做成偏序标签注入 pairwise loss,成本几乎为零。CRRN 的 Table IV 还额外告诉你该选哪个属性做粒度(类目 > 价格 > 品牌 > 店铺),并给出了判定依据(属性内部的多样性不能太高)。
- "参数更少反而更好"的相似度选择。Table V 显示余弦相似度打败了 MLP / bilinear / 对比学习预训练。当一个标量的职责是充当语义先验的调节器而非拟合目标时,让它可学习反而会被主目标带偏——这个经验对所有"用相似度做门控"的设计都适用。
- 级联优于并行的注意力顺序。让 trigger attention 在 target attention 的输出之上再做一次激活,而不是两塔并行后拼接,是一个低成本的结构改动,CIF 也是消融中单模块增益最大的(+0.78 点)。
局限与争议
- 创新幅度是增量的。CRRN 是 DIHN → DIAN → DEI2N 这条 TIR 谱系上的又一次改良,三个模块都由标准组件搭成(两层 MLP 门控、多头注意力、余弦、pairwise loss),没有引入新的建模范式。相对最强 baseline DEI2N 的绝对增益只有 0.29 / 0.20 个 AUC 点,且未报告方差或显著性检验。
- 三个模块高度冗余。如前文分析,单模块增益之和(1.75 点)远大于完整模型增益(1.04 点),说明 TTI / CIF / CPL 在很大程度上注入的是同一个类目相关性信号。论文把它们当互补组件叙述,但没有做两两组合的消融来厘清冗余度。
- 线上 A/B 的对照组偏弱。线上对比的是 DIN+TAR(论文自述的"previous online model"),而不是离线最强的 DEI2N。因此 +3.87% CTR 反映的是"CRRN vs 一个较老的线上模型"的差距,无法说明 CRRN 相对同代 TIR SOTA 的线上收益。同理 Table III 的消融基线也是 DIN+TRA 而非 DEI2N。
- 公开数据集的 TIR 属性是构造出来的。公开数据集缺 trigger,论文用"4 小时内最近一次点击"人工合成 trigger,并丢弃无 trigger 的样本。这个代理与真实 TIR 的语义(用户主动点击进入承接页)差别不小,且丢弃样本会改变数据分布,因此公开数据集上的数字更适合看相对排序而非绝对水平,也不宜与标准 Alimama/TaobaoAd 划分上的其它工作横向比较。
- 公式书写存在多处问题(本文照录原文并已逐处标注):式 (10) 的 $\log(\hat{y}^i - \hat{y}^j)$ 在差值为负时无定义,应为 $\log\sigma(\cdot)$;式 (6) 的 target attention query 写成了 $E_t$,与正文和 Fig 2 的 $E_i$ 矛盾;式 (7) 漏了 $K^\top$ 且把 $V$ 写进了 softmax;式 (9) 分母原文印为 $\lVert E_i^\top\rVert\lVert E_i\rVert$(应为 $\lVert E_t\rVert\lVert E_i\rVert$);符号 $\hat{y}_{tri}$ / $\hat{y}_{int}$ 混用;Table III 表头 "IEF" 与正文 "CIF" 不一致;模型名在正文/表格间在 DEI2N/DIE2N、DIN+TAR/DIN+TRA、Wide&Deep+TIR/+TR 之间反复摇摆。这些不影响核心思想,但会给复现带来摩擦(好在代码已开源)。
- 融合权重不构成凸组合。式 (8) 中两路权重为 $\hat{p}\cdot s$ 与 $(1-\hat{p})(1-s)$,二者之和一般不等于 1;且余弦相似度 $s \in [-1, 1]$ 可为负,此时 $\hat{p}\cdot s$ 会给 $V_{tri}$ 一个负权重、同时 $(1-s) > 1$ 会放大 $V_{tar}$。论文既未说明是否对 $s$ 做了归一化到 $[0,1]$,也未讨论这一情形下 $V_{fuse}$ 的尺度漂移问题。
- 意图标签存在潜在的信息泄漏风险。意图标签取自"该页面上被点击的物品是否与 trigger 同类目",而 CTR 标签本身就是"该样本是否被点击"。同一页面内的正样本既贡献 CTR 标签又参与构造意图标签,训练时这个辅助任务可能间接泄漏当前样本的标签信息。论文只说明标签"推理时不使用",未讨论训练期的泄漏问题。
- 方法论可扩展性受限。CRRN 是一套手工设计的、模块固定的交互结构,序列长度固定为 100,没有任何 scaling 实验。扩参时"如何表征历史"(固定长度的多头注意力)与"如何建模交互"(固定的两层门控 + 单层级联)都无法同步扩展,属于典型的架构容量受限路线——这与 HSTU / RankMixer / FAT 那类以 scaling 为核心命题的工业排序架构形成对照。
- Table VII 的口径存疑。表中 IPV/PV = 0.87/19.70 ≈ 4.42%,与所报 CTR 3.11% 对不上,说明 CTR 的分母并非 PV,但论文未说明;正文又把 pCTR 描述为"用户在 TIR 场景点击的平均物品数"(那是 IPV 的定义),表述混乱。此外 A/B 时间窗写作"4 月 10 日至 17 日"而工业数据集采样自 2025 年 8–10 月,年份未注明。
工业落地价值
CRRN 的工业价值是明确且已兑现的:已在 Tmall 全量上线,线上 CTR +3.87%、IPV +5.75%、PV +3.25%,L20 GPU 上单次推理仅 45ms(较原线上模型 +2ms,远低于 150ms 的服务预算),训练开销与同类 TIR 方法持平。更有价值的是 Table VIII 那组线上推荐分布统计,它证明模型带来的不只是打分微调,而是推荐结果结构的实质位移(同类目占比 40.51% → 67.45%,异类目 52.33% → 11.24%),并且论文清醒地把"保留 11% 异类目"当作刻意保留的多样性预算而非残留误差。对于任何做"相关推荐/承接页推荐"的团队,CPL 与 coaction 门控都是可以低成本移植的两个组件。